
トムソン・ロイターが自社開発の大規模言語モデルThomsonを発表しました。
法情報サービス大手のトムソン・ロイターが、自社で開発した大規模言語モデル「Thomson」のベンチマーク結果を公開しました。開発予算は約4,000万ドル、学習に使ったのは自社が保有する法務コンテンツのおよそ8%にとどまるとされています(出典: The Globe and Mail)。フロンティアモデルを借りる側だった士業向けツールのベンダーが、自らモデルを持つ側に回り始めた事例として注目されます。本記事は公表資料と報道をもとに、士業事務所のツール選定に関わる論点を整理したものです。
何が公表されたか|自社LLM「Thomson」のベンチマーク
公表されたのは、トムソン・ロイターが2024年に買収した Safe Sign Technologies を起点に開発してきた自社モデルの初回ベンチマークです。法律テック専門ブログの LawSites によると、CTO の Joel Hron と AI 研究責任者の Jonathan Schwarz が7月31日の同社イノベーションブログで結果を示しました。
モデルはオープンソースの基盤モデルから出発し、Westlaw、Practical Law、Checkpoint、ロイターのコンテンツで追加学習されています。開発予算が約4,000万ドル、学習に投入した自社コンテンツが全体の1割未満という点は、The Globe and Mail が伝えたロイターの報道でも触れられています。
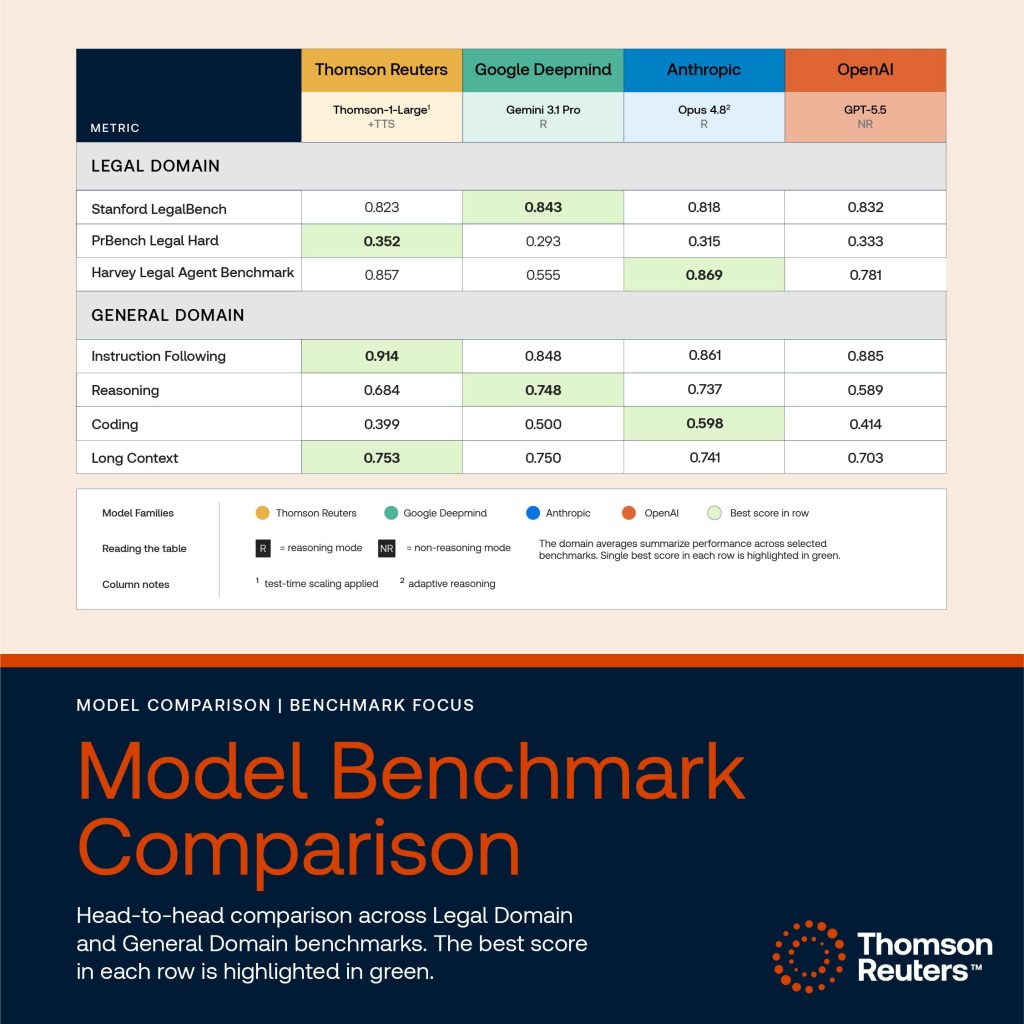
数値は同社の自己申告です。LawSites がまとめたスコアでは、Thomson-1-Large は法務系の PrBench Legal Hard で0.352と首位、Harvey Legal Agent Benchmark で0.857と Claude Opus 4.8(0.869)に次ぐ2位でした。一方、最も知られた Stanford LegalBench では0.823で、Gemini 3.1 Pro(0.843)と GPT-5.5(0.832)の後塵を拝しています。コーディングは0.399で最下位でした(出典はいずれも前掲 LawSites)。
数値の読み方|第三者検証はまだ行われていない
このベンチマークには前提条件の非対称があります。LawSites によれば、Thomson 側はテスト時スケーリング(推論時に計算量を増やす手法)を使い、GPT-5.5 は推論モードではない状態で測定されました。Hron はテスト時スケーリングの効果について、全体平均が0.787から0.789に上がった程度で結論は変わらないと説明しています。GPT-5.5 の推論モード評価は公開に間に合わなかったとのことです。
もう一つの評価では、Westlaw と Practical Law に接続した Thomson と、Brave 検索でウェブ全体を参照するフロンティアモデルを、53件の法務リサーチ設問で比較しています(出典: LawSites)。LawSites はこれを「モデルの比較というより、背後にある検索対象の比較に近い」と評しました。同一のコンテンツを与えた条件では4モデルのスコアが0.81から0.91の範囲に収まり、Thomson は0.89だったと Hron は述べています。
いずれも独立した第三者検証は行われていません。Hron 自身も、第三者による評価が重要になるとの見解を示しています。
士業事務所にとっての論点|学習データとベンダー依存
士業読者にとって重要なのは、まず入力データの扱いです。LawSites の記事では、顧客データは学習に使われないと同社が説明したことが報じられています。日本の事務所が Westlaw Japan などを通じて Thomson に触れる時期や条件は、現時点の公表資料からは確認できません。導入判断の前に、契約書とプライバシーポリシーで学習利用の有無を確認する段階です。
もう一つは、ベンダーの内部モデル差し替えという論点です。MarketScale は Bloomberg Law の報道を引きながら、Harvey も Tenet という独自モデルを投入しており、法務AIベンダーが推論コストと依存度を下げる方向に動いていると整理しています。同記事は、自社モデルを運用すればセキュリティ上の責任もベンダー側に移るという ZwillGen の Brenda Leong の見方も紹介しています。
画面が同じままでも、裏側のモデルと副処理者が入れ替わることがあります。契約上どのモデルを使うと定めているか、変更時に通知があるかを確認しておく事務所があります。士業向けツールの選び方については、ベンチマークの読み方やモデル選定とコストの考え方でも取り上げています。
今後の動き
Thomson の最初の実装は、CoCounsel Legal の Tabular Analysis の既定モデルとしての採用です。今後1年で法務・税務の製品群に広げるとされています。業績面では、ロイターによると第2四半期の売上が9%増の19億5,000万ドル、生成AIに依拠する契約価値の比率は30%から32%へ上昇しました。CEO の Steve Hasker は、大口顧客向けのソブリンAI提供の可能性にも言及しています。
法情報のコンテンツを持つ側がモデルまで垂直統合していくのか、フロンティアラボが法務領域へ降りてくるのか。事務所の収益モデルにも波及しうる競争なので、続報を追う価値があります。
まとめ
トムソン・ロイターが約4,000万ドルで自社LLM「Thomson」を開発し、自己申告のベンチマークを公開しました(出典: The Globe and Mail、LawSites)。法務系の一部指標では首位ですが、LegalBench では大手モデルに及ばず、測定条件にも非対称があります。第三者検証はこれからです。士業事務所としては、学習データの扱いとベンダーのモデル差し替えの2点を確認する段階といえます。
参考文献
- LawSites Thomson Reuters Says Its Homegrown AI Model Now Rivals the Frontier Labs
- The Globe and Mail Thomson Reuters to roll out in-house AI model as quarterly revenue rises
- MarketScale Legal AI vendors are building their own models to cut inference bills and reduce platform dependence
- Reuters Thomson Reuters AI Model to Challenge Anthropic, OpenAI and Google
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。