
MicrosoftなどのチームがAIエージェントの判断力を測るTaste-Benchを公表しました。
MicrosoftとCity University of Hong Kongの研究チームが、長い作業の途中でAIエージェントがより良い次の一手を選べるかを測るベンチマーク「Taste-Bench」を公表しました。14のモデルを比べたところ、最も高い正答率でも59.7%にとどまったと報じられています。AIに調査や資料作成を任せる場面が増えるなか、士業事務所がツールの得意不得意を見極める材料になりそうです。本記事では、公表された数字と評価の仕組みを整理します。なお、本記事は公表資料の要約であり、特定の業務判断を示すものではありません。
何が起きたか:判断力を測る502問のベンチマーク
報道したのはThe Decoderで、公表日は2026年10月18日です。ベンチマークの開発者は、論文「The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks」(arXiv:2609.25804)の著者であるWenbo Pan氏らです。コードと評価ツールはGitHubのTaste-Bench、データはHugging Faceのデータセットで公開されています。
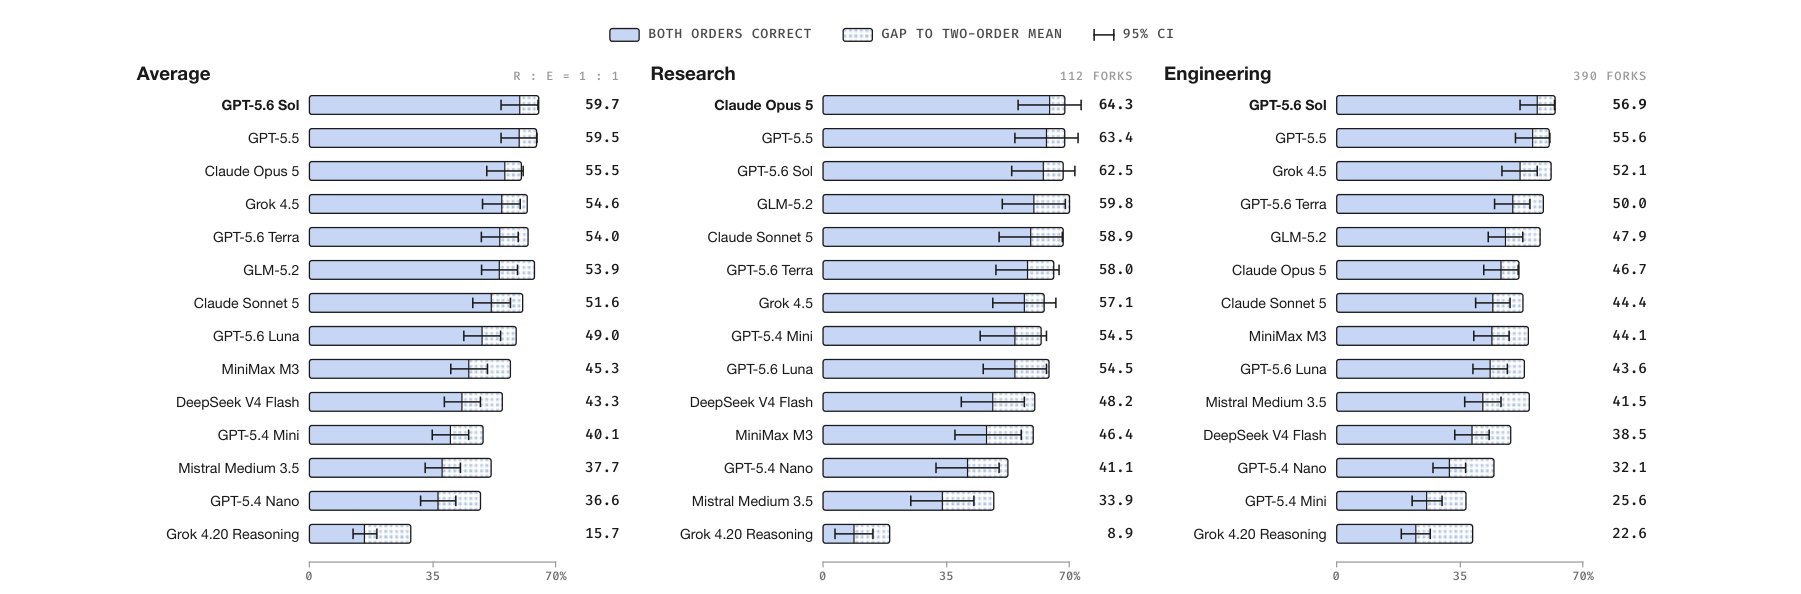
問題数は全502問です。内訳はソフトウェア工学が390問、機械学習研究が112問で、SWE-benchやMETRのMALTといった既存の作業記録から作られています。各問題では、エージェントの作業記録と二つの候補が示され、技術的により良い次の一手を選びます。正解は専門家の注釈ではなく、その後の作業の結果で決まる仕組みです。
分岐の種類は二つあります。一つは、同じ課題を独立に二度試し、途中で分かれた結果の良し悪しで正解を決めるものです。もう一つは、エージェントが進んだ道を失敗して引き返した場合に、放棄した道と回復後の道を比べるものです。
採点は厳しめです。同じ問題を選択肢の順序を入れ替えて二回出し、両方で正解したときだけ正解と数えます。そのため当てずっぽうの正答率は25%で、常に同じ位置を選ぶと0点になります。
結果の読み方:最高でも59.7%、後半ほど苦手
公開されている順位表では、GPT-5.6 Solが59.7%で最も高く、GPT-5.5が59.5%、Claude Opus 5が55.5%と続きます。下位にはMistral Medium 3.5の37.7%などが並びます。解析できない回答を不正解として数える設計のため、出力形式に失敗したモデルは点数が大きく下がります。
The Decoderの報道によると、判断に必要な手がかりが作業の前半に見えている場合の平均正答率は62.3%でした。これに対し、手がかりが長い作業の後半にしか現れない場合は21.0%まで下がったとされています。推論の設定を最低から最高に引き上げても、GPT-5.6 SolとGPT-5.6 Lunaではほとんど改善しなかったとのことです。
改善の方向も示されています。教師モデルの判断を蒸留して学習させた小型モデル(Qwen3.6-27Bが基盤)では、判断の正答率が30.0%から47.9%に上がりました。そのアドバイスを使うと、SWE-bench Proの41タスクでの成功率が、助言なしの14.6%から33.7%に上がったと報じられています。ただしこの41タスクという規模は小さく、数字の幅は慎重に見る必要があります。
士業×AIの視点:ツール選定で参考になる点
この結果は、個別の製品を士業事務所へ導入する話ではありません。ただ、書類の下調べや複数の手順をつなぐ作業をAIエージェントに任せる場合、途中の方針選びが成果を左右するという論点は共通します。判断の根拠が長い作業の後半で初めて分かる場面ほど、AIの選択が当たりにくいと報告されている点は、結果を人が確認する段階を設ける際の材料になります。
データの取り扱いについては、この公表資料からは確認できません。評価データは学習への混入を避けるためゲート付きで公開され、規約でデータ項目の再投稿が制限されています。事務所で実際のツールを検討する場合、入力した情報が学習に使われるかどうかは、各ベンダーの公式ポリシーで個別に確認する段階です。
今後の動き:注目したいポイント
研究チームは、Taste-BenchがSWE-bench Verifiedとは別の能力を測ると述べています。今後は、順位表に新しいモデルが加わったときに、後半に手がかりが現れる問題の正答率が上がるのかが注目点です。蒸留による改善が、より大きなタスク数でも再現されるかも確認したいところです。
順位表は更新される可能性があるため、数字を引用する際は確認した日付を併記するのが無難です。本記事の数値は2026年10月18日時点の公開情報に基づきます。
まとめ
Taste-Benchは502問でAIエージェントの判断力を測り、最高でも二択の正答率は59.7%でした。手がかりが作業の後半に現れる問題では平均21.0%まで下がり、推論の設定を上げても改善しなかったと報じられています。数字の大きさだけでなく、何をどう測った調査なのかを併せて見ることが大切です。
参考文献
- The Decoder AI agents have bad taste in long-term decisions and a new benchmark proves it
- GitHub wbopan/tastebench
- Hugging Face wenbopan/taste-bench
※士業のチカラでは、士業事務所向けにAI活用の情報を発信しています。ご相談は下記からお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。