
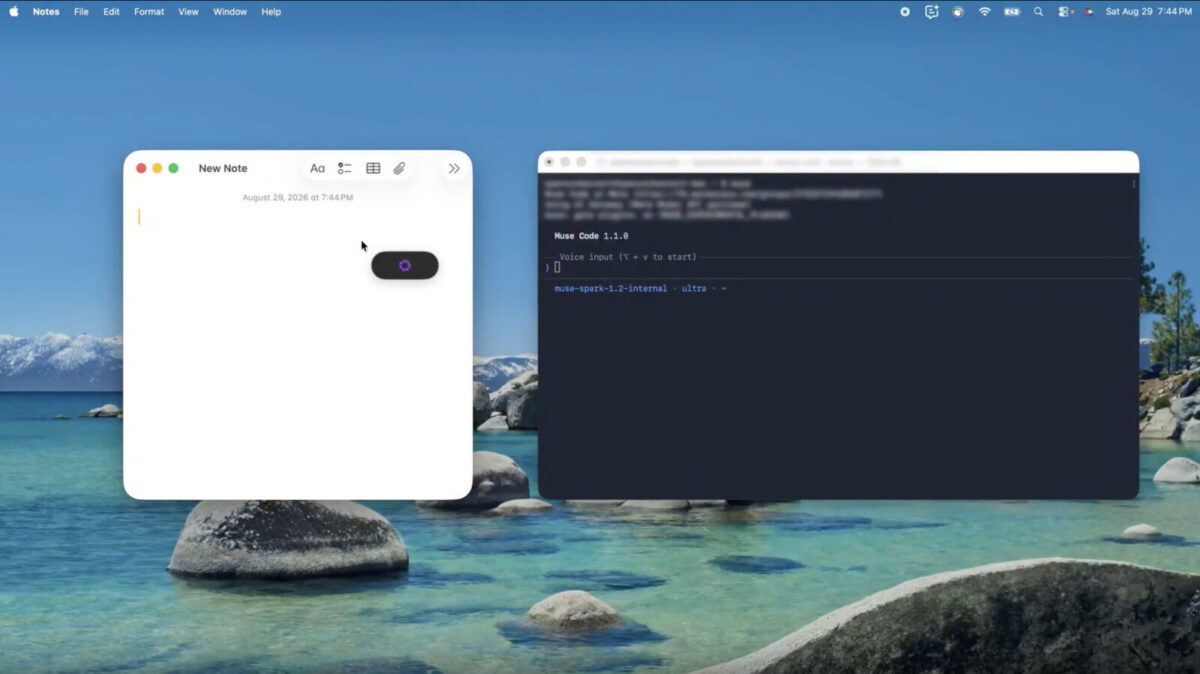
Metaは2026年9月1日、リアルタイム文字起こしモデル「Muse Voice Transcribe」を公開しました。
音声の文字起こしは、これまで「録音が終わってから処理するもの」でした。Metaが公開したMuse Voice Transcribeは、その前提を崩しにきています。話しているそばから文字に変え、しかも誰が話しているかをリアルタイムで分けます。20人を超える参加者がいる1時間超の会議でも動くとされ、価格は音声1時間あたり0.18ドル。士業事務所の打ち合わせ記録やヒアリングの現場に、直接効いてくる種類の発表です。本記事は公表資料と報道をもとに事実関係を整理したもので、有資格者による法的助言ではありません。
Muse Voice Transcribeで何が発表されたか
発表内容の核は、ストリーミング文字起こしと話者分離とエンドポイント検出を、1つのモデルで同時にこなす点にあります。Dataconomyによれば、Muse Voice TranscribeはMeta Superintelligence Labs(MSL)にとって初のリアルタイム音声知覚モデルで、Meta Model API、Muse Code、そしてMeta AI Macアプリから利用できます。
従来の文字起こしパイプラインでは、まず音声認識をかけ、そのあとに別の後処理で「この発言は誰か」を割り当てるのが一般的でした。Muse Voice Transcribeはその話者分離を後処理に回さず、モデル内部で処理します。音声は80ミリ秒ごとの塊(毎秒12.5回)で読み込まれ、その都度モデルが「まだ聞き続けるか、いま文字を出すか」を判断する設計だと説明されています。Mark Zuckerbergは自身のX投稿で、難しい語では少し待ち、簡単な語では早く確定する適応的な遅延を使うと述べています。
学習は70を超える言語で行われ、うち25言語がリリース時点で検証済みとされています。文の途中で言語が切り替わるコードスイッチングにも対応するとされ、日本語と英語が混ざる商談や国際案件の打ち合わせのような音声を想定しやすい仕様です。
数字で見ると何が新しいのか
新しさは精度そのものよりも、精度と価格と即時性が同時に成立している点にあります。VentureBeatによると、モデルはMeta Model API上で muse-voice-transcribe-1.0 として提供され、価格は音声1,000分あたり3.00ドル、時間換算で0.18ドルです。
精度面では、MarkTechPostが伝えるMetaの公表値として、AMI-IHM、AMI-SDM、VoxConverseの3つのベンチマーク平均で話者分離エラー率17.5パーセントという数字が示されています。同じ比較図に載る他の5システムは21.1パーセントから28.6パーセントの範囲とされており、リアルタイム処理でありながら差をつけた形です。ベンチマークの条件と実際の会議室の音響環境は異なるため、この数値がそのまま自分の事務所で再現されるとは限らない点は留めておく必要があります。
この分野の動きは速く、Googleは今回の発表の1週間足らず前にGemini 3.5 Transcribeを公開しています。音声認識は数年単位で安定していた領域でしたが、いま数週間単位で選択肢が入れ替わる局面に入りました。
士業事務所がこのニュースをどう読むか
士業の業務は、実は音声の塊でできています。弁護士の法律相談、社労士の従業員ヒアリング、会計士の監査でのインタビュー、税理士の決算打ち合わせ。いずれも複数の人が話し、誰が何を言ったかが後から効いてきます。話者分離が後処理なしで走る文字起こしは、この記録作業に直接届く技術です。実際、リアルタイム処理であれば、面談中に画面へ文字が出ている状態で進行でき、記録係を1人立てる前提そのものが変わり得ます。
一方で、士業がこの種のツールを検討するときに最初に見るのは精度でも価格でもなく、入力した音声がどう扱われるかです。MetaはLlama APIの提供開始時に、APIの入力と出力を自社モデルの学習には使わないと説明していました。ただし、Muse Voice Transcribeを含む現行のMeta Model APIに同一の取扱いが適用されるかどうかは、今回確認できた公表資料からは判断できません。ここは要確認の項目です。相談者や従業員の音声という、生の個人情報かつ守秘義務の対象になり得るデータを扱う以上、ベンダーの利用規約とデータ保持ポリシーを一次資料で読むところから始める事務所が多くなりそうです。
録音そのものの同意取得、録音データの保管場所と保管期間、外部APIへ送る前のマスキングの要否。この3点は、ツールの性能とは別軸で整理が必要になる論点として残ります。
今後の動き
Metaは今のところ、Muse Voice Transcribeを主要な消費者向けサービスへ組み込む計画を示していないと報じられています。当面はAPI経由での利用と、Meta AI Macアプリのディクテーション機能を通じた広がりが中心になりそうです。MSLはここ数週間でコーディングエージェント、オープンウェイトモデル、Meta AI Macアプリを立て続けに出しており、その流れの一環という位置づけになります。
注目したいのは、リアルタイム話者分離が「特別な機能」から「標準で付いてくるもの」へ移っていくかどうかです。そうなれば、士業向けの業務システムやクラウド会計、案件管理ツールの側が音声入力を前提に作り替えられていく可能性があります。
まとめ
Muse Voice Transcribeは、リアルタイムの文字起こしと20人超の話者分離を1モデルで、1時間0.18ドルで提供するモデルです。音声記録が業務の中心にある士業事務所にとって、性能面の条件は整いつつあります。残るのは、音声データの取扱いをどう確認し、どこまで外部に出すかという判断です。
参考文献
- Dataconomy「Meta unveils real-time voice model that transcribes 20 speakers」
- VentureBeat「Meta prices Muse Voice Transcribe at $0.18 an hour」
- MarkTechPost「Meta Superintelligence Labs Releases Muse Voice Transcribe」
- Mark Zuckerberg の X 投稿(2026年9月1日)
- AI at Meta の X 投稿(2026年9月1日)
- Meta for Developers「Llama API」
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: Dataconomy
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。