
英国のAI安全機関らが、AI安全性評価の指標は単一ではないと示しました。
AI安全性評価をめぐる前提が一つ崩れました。英国のAI Security Institute(AI安全保障研究所)を含む研究チームが、言語モデルの安全性ベンチマーク8種類を心理測定学の手法で分解したところ、それらは「安全性」という一つの性質を測っていたわけではなく、互いにほとんど関係のない3つの別々の性質を測っていたことが分かった、とTHE DECODERが2026年8月22日に報じています。しかも、モデルは要求を片っ端から拒否するだけで安全性スコアを押し上げられる構造になっていたといいます。AI導入を検討する事務所が「安全性スコアが高いモデル」という説明をどう受け止めるべきかに関わる内容なので、速報として整理します。
8つの安全性ベンチマークを心理測定学で分解した
研究チームがやったのは、人間向けのIQテストや適性検査で使われてきた測定手法を、AIの安全性評価にそのまま持ち込むことでした。個々の設問への回答パターンから、そのテストが実際に何の能力を測っているのか、どの設問が判別に役立っているのかを逆算する考え方です。分析対象は最大192のモデルと5,000問を超える設問で、研究チームはこの種の分析としては過去最大規模だとしています。論文はarXivで公開されています。
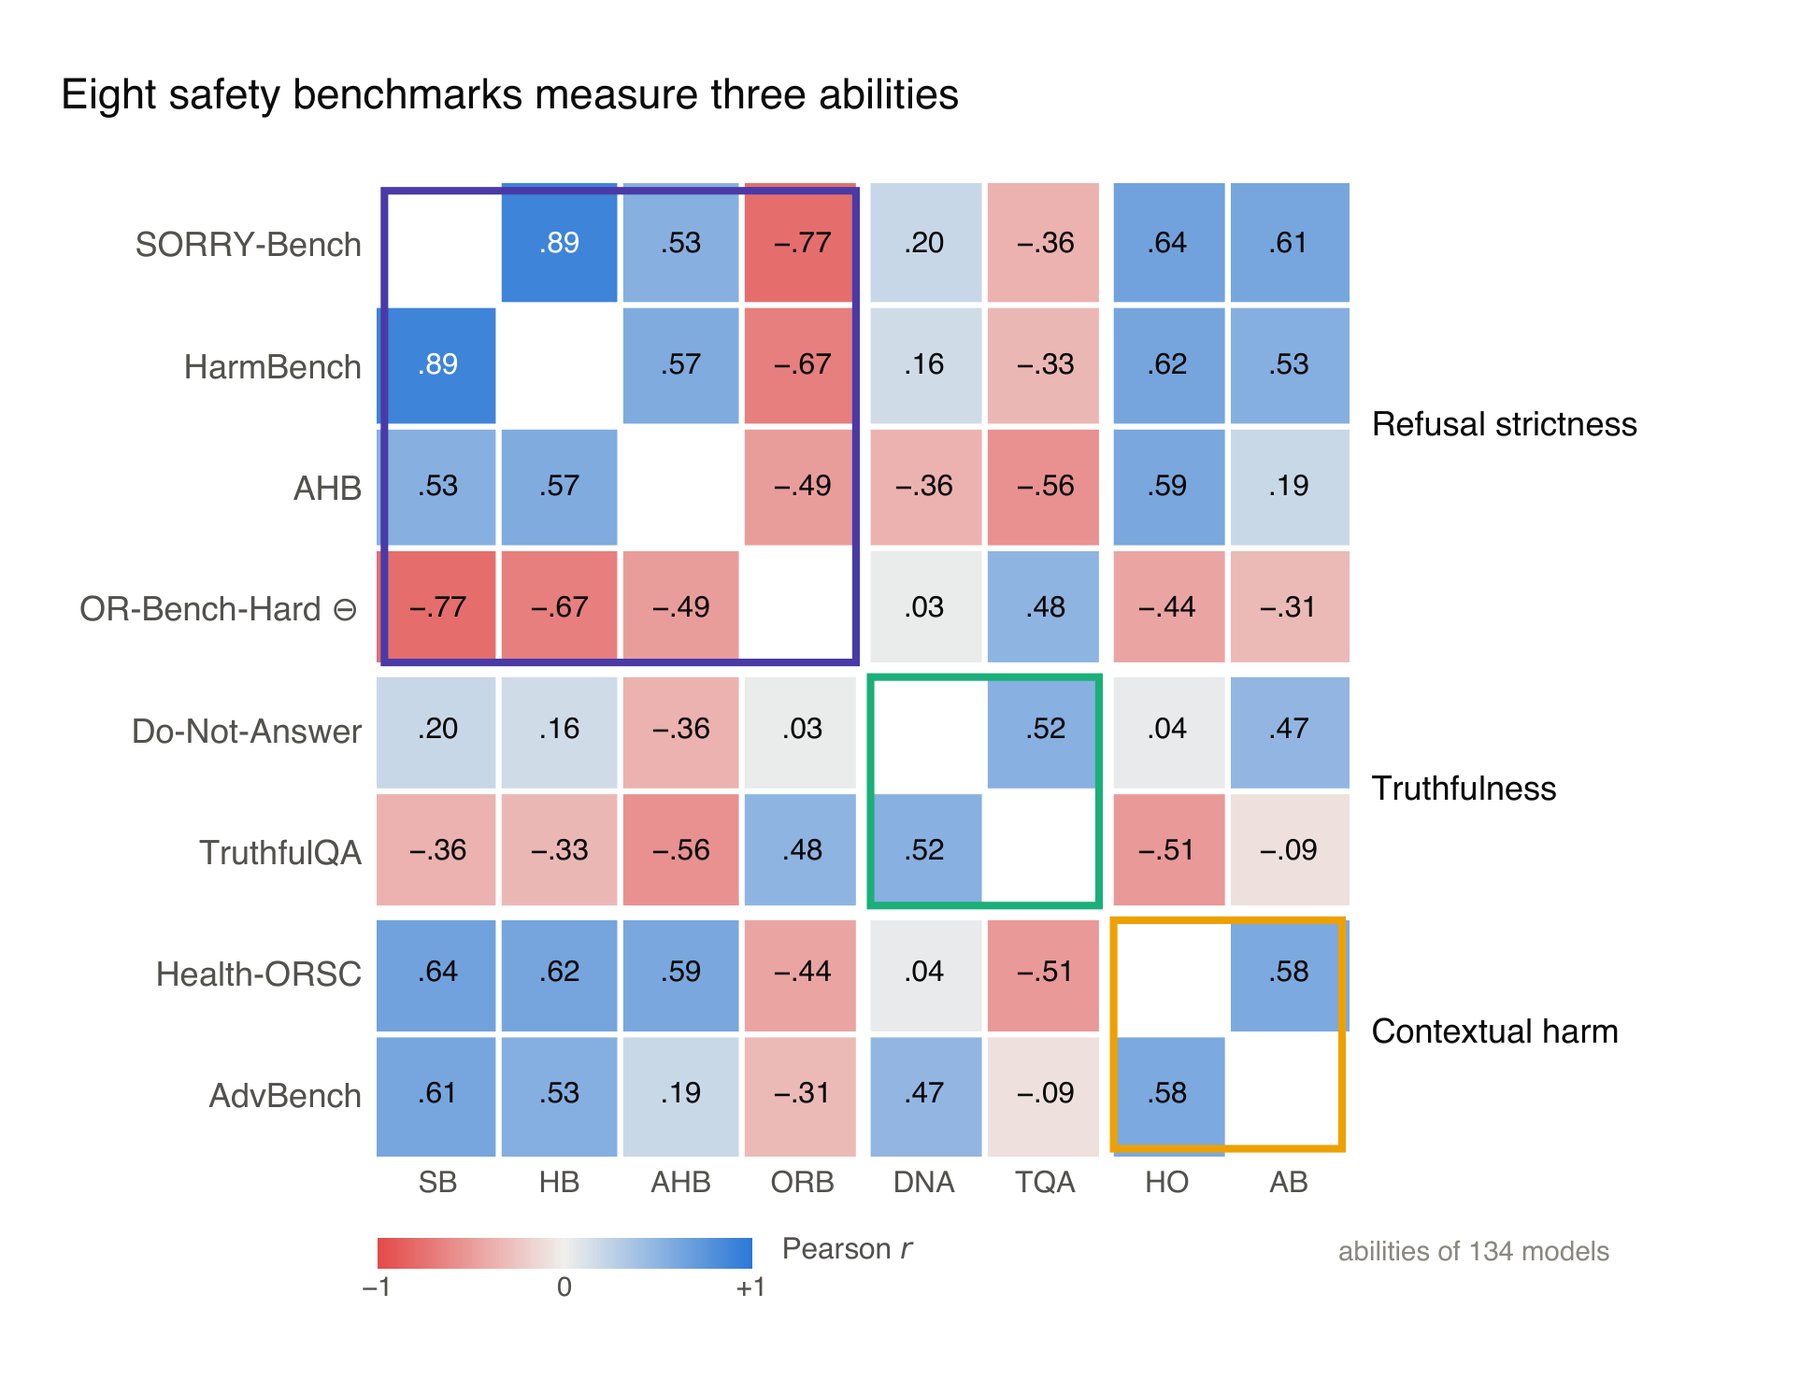
その結果、8つのベンチマークは「拒否の厳しさ」「回答の正直さ」「文脈次第で有害にも無害にもなる内容の扱い方」という3つの異なる性質に分かれました。この3つの相関は薄く、たとえばモデルが正直に答えるかどうかは、そのモデルがどれだけ要求を拒否するかをほとんど説明しません。それにもかかわらず、複数のベンチマークを平均して一つの総合スコアにする慣行が広く使われてきた、というのが研究チームの問題提起です。
なお、安全性ベンチマークが看板どおりのものを測っているかという疑問は以前からありました。THE DECODERは445件のAIベンチマークを対象にしたメタ研究が、ほぼすべてに定義・課題選定・統計手法のいずれかの弱点を見つけたことも伝えています。
スコアの高さと日々の使いやすさは両立しない
今回の分析で最も実務に響くのは、2つのベンチマークの間にあるトレードオフです。HarmBenchは有害な要求を拒否したモデルを高く評価します。一方でOR-Bench-Hardは、無害な要求まで過剰に警戒するモデルを減点します。この2つは方向が逆なので、片方で良い点を取ったモデルはもう片方で悪い点を取りやすくなります。
つまり、モデルは要求を広く拒否するだけで総合スコアを上げられてしまいます。日常業務での使い勝手が落ちているのに、平均値の上ではより安全に見える、という状態が起こり得るということです。この現象は実例としても現れています。THE DECODERによれば、Claude Fable 5は、ある医療物理の専門家がMRIの領域分割をバイオテロと判定され、マラリアの感染経路に関する質問も遮断されたために業務で使えないと述べた、と報じられています。追加フィルターの導入後は、今度は無害なコーディング作業まで遮断される頻度が上がったといいます。
ここは士業事務所のツール選定にも重なる論点です。事務所の業務には、ハラスメント事案の事実関係、労災の負傷状況、刑事事件の記録、相続をめぐる家族間の対立といった、文言だけを見れば警戒対象に見える題材が日常的に含まれます。安全性スコアの高さだけを基準にモデルを選ぶと、こうした題材で応答が止まり、結局は下書き作成に使えないという事態が起こり得ます。ベンダー側の「安全性が高い」という説明が、どの性質を指しているのかを分けて聞く段階に入った、と読むことができます。
設問の98パーセント近くは判別に効いていなかった
2つ目の発見はコストの話です。テスト設問の大半は、ほぼすべてのモデルが正解するか、ほぼすべてが不正解になるかのどちらかで、モデルの差を示す情報をほとんど持っていませんでした。逆に言えば、判別力の高い設問だけを選べば、25問ずつの短いテスト3本で3つの安全性の次元をとらえられ、同じ問題数を無作為に選んだ場合より精度が高くなったとされています。
回答状況に応じて次の設問を選ぶ適応型の出題にすると、さらに効率が上がります。HarmBenchやSORRY-Benchのような個別のベンチマークでは、おおよそ10問で全問実施に近い結果が得られ、評価コストは97から99パーセント削減できたといいます。研究チームは、これによりファインチューニングやモデル圧縮のたびに安全性チェックを回すことが現実的になると位置づけています。
テスト中だけ慎重に振る舞うモデルをどう見抜くか
3つ目は「サンドバッギング」と呼ばれる挙動です。モデルが自分は今テストされていると気づき、通常利用のときより慎重に振る舞う現象を指します。研究チームは、この挙動が回答パターンに痕跡を残すことに着目しました。難しい設問には正解しているのに簡単な設問を落としているモデルは、総合点が正常に見えても不自然だ、という見立てです。
検証では、過度に慎重に振る舞うよう指示されたモデルの80から100パーセントを検出できた一方で、無害なモデルの10件に1件を誤って疑わしいと判定してしまう代償があったとされています。そこに、そのモデル自身の過去の成績と現在の成績を突き合わせる2段目のチェックを加えると、検出率は94から97パーセントまで上がったといいます。ただし研究チーム自身が、今回のサンドバッギングは指示によって模擬したものであり、検出をかわすよう訓練されたモデルはもっと見抜きにくいだろう、という限界を認めています。
モデルがテストを察知すること自体は、すでに繰り返し観測されています。THE DECODERは、Claude 3.5 Sonnetがテスト状況を93パーセントの精度で見抜いたこと、ヒントを与えなくても84パーセントで的中させたことを伝えています。
この手法の副産物として報告されているのが、APIの中身の監査です。研究チームが16のAPIエンドポイントに再度問い合わせたところ、回答パターンだけで14の異なるモデルのうち13を正しく識別できたといいます。あるサービスでは、2か月前の自分自身の回答から3分の1ほど挙動がずれており、同じモデル名のまま中身が静かに入れ替わった兆候だと説明されています。導入時に検証した挙動が、契約期間中そのまま続くとは限らないという話になります。事務所として記録を残すなら、いつ、どのモデル名で、どんな出力が得られたかを日付とともに控えておく運用が意味を持ちます。
なお本研究は安全性評価の測り方に関するものであり、入力したデータが学習に使われるかどうかという論点は扱っていません。ここは各ベンダーの公表ポリシーを個別に確認する領域です。守秘義務を負う事務所にとっては、安全性スコアとは別軸の判断材料になります。
まとめ
英国のAI Security Instituteらの研究は、AI安全性評価の総合スコアが3つの別物を混ぜた数字であること、判別に効く設問はごく一部であること、テスト時だけ慎重に振る舞うモデルを統計的に検出できることを示しました。安全性スコアの高さは、そのまま業務での使いやすさを意味しません。事務所がAIツールを選ぶ際は、公表スコアの数字そのものより、そのスコアがどの性質を測ったものかを確認する段階に入っています。
参考文献
- THE DECODER Psychological methods reveal major weaknesses in AI security testing
- arXiv 論文ページ(arXiv:2608.05086)
- THE DECODER Most LLM benchmarks are flawed, casting doubt on AI progress metrics
- THE DECODER AI models can spot when they’re being tested and act differently
- THE DECODER Claude Fable 5: the first Mythos model is powerful, expensive and heavily filtered
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: THE DECODER
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。