
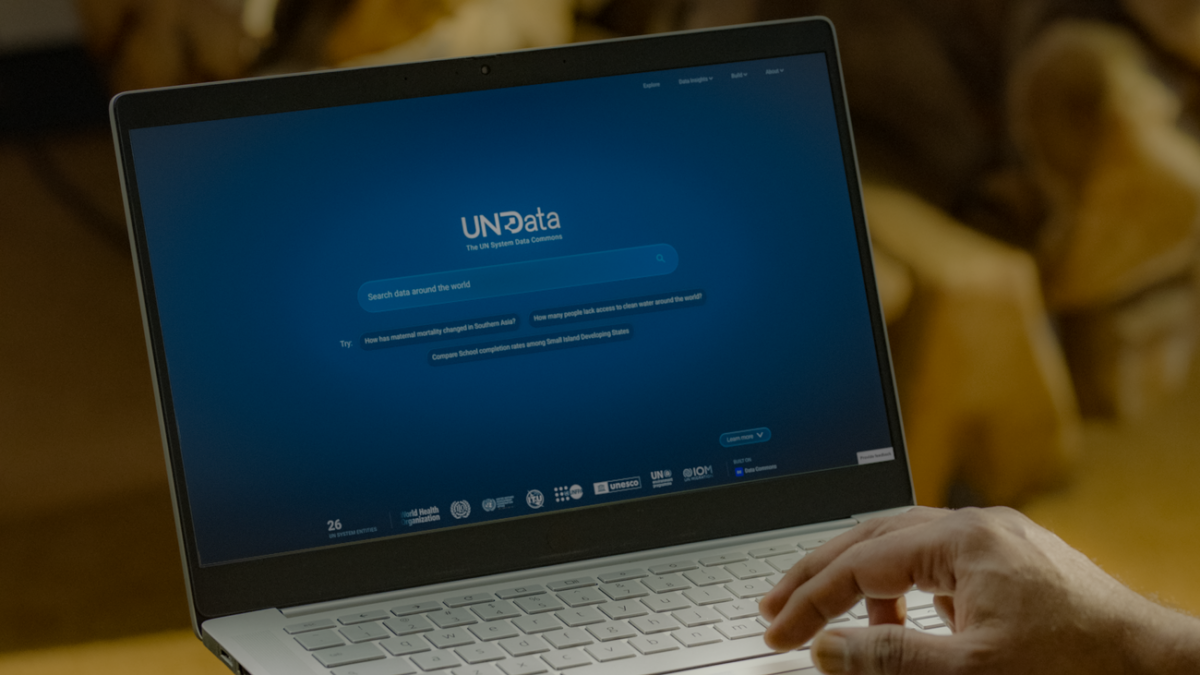
国連は2026年9月17日、統計をAIが直接参照できる新基盤を公開しました。
国連システムの各機関が持つ統計を1か所に集め、AIから直接参照できる形に整えた基盤が公開されました。名称はUN System Data Commonsで、Googleのオープンソース基盤Data Commonsの上に構築されています。背景には、生成AIに開発指標を尋ねたときの正答率が平均21.2%にとどまったという検証結果があります。本記事は一次資料へのリンクを添えて事実関係を整理したものです。士業事務所が成果物に数字を載せる場面と、どこが重なるのかを見ていきます。
何が起きたか:国連の統計が1つのAI対応基盤に集約されました
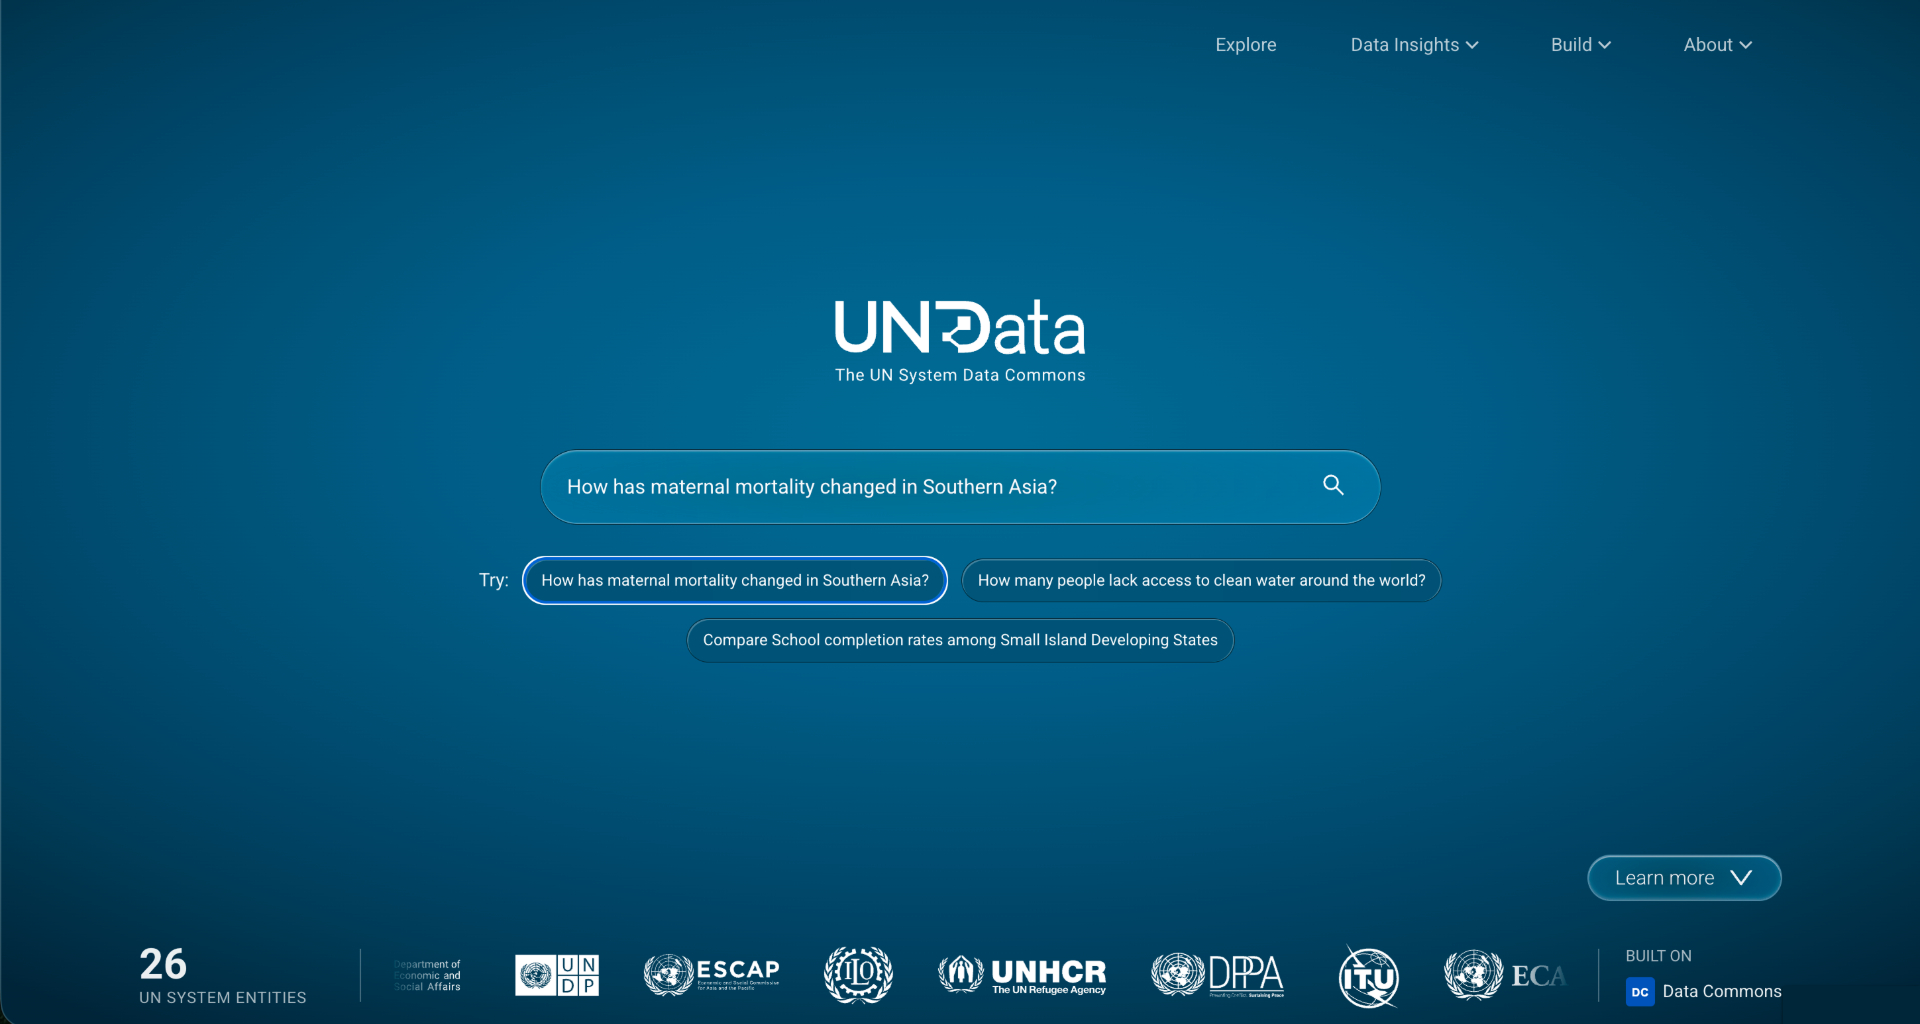
結論として、複数機関にまたがっていた国連の統計が、機械が読める1つの知識グラフにまとめられ、自然言語で検索できるようになりました。Googleの公式ブログThe Keywordによれば、これまで統計は機関ごと、さらには同じ機関の中でも異なる形式で散在しており、複数のデータをつなぐには分析者が数か月かけて手作業で整形する必要がありました。新基盤は指標、時系列、地理的な境界の定義を自動的に統合し、従来のUNDataポータルを置き換えます。
技術面で注目されるのは、Model Context Protocol(MCP)に対応した点です。MCPはAIを外部のデータソースに接続するための共通規格で、これによりAIエージェントが権威ある数値を自分で取りに行き、分野をまたいで組み合わせ、図表や下書きレポートの形にまとめる流れが想定されています。Data Commons責任者のPrem Ramaswamiは、同ブログで、検証済みのデータであっても重要な数値を引用する前に元の出典を確認するよう書いています。
TechCrunchの報道によれば、26の国連機関が参加を表明し、公開時点では約20機関分のデータが利用できます。2027年までに国連システムの統計データセットの80%を載せることが目標とされています。Google.orgは中核インフラの立ち上げに200万ドルの資金と技術支援を提供しましたが、基盤自体は国連が管理するインスタンス上で動き、将来的には国連側が独立して運用することが想定されています。各統計がどこから来たかを追跡する仕組みも備わっており、AIが取ってきた数字を元の出典までたどれる設計です。
なぜ動いたか:正答率21.2%という検証結果
この整備が動いた理由は、AIに統計を尋ねても信頼できる数字が返ってこないという実測があったからです。同じくTechCrunchによれば、ユニセフの主任統計官であるJoão Pedro Azevedoは記者向けのオンライン説明で、6つの大規模言語モデルに世界の開発指標を尋ねた13万3千件超の応答を評価したところ、平均の正答スコアが21.2%だったと述べました。対象となったのはGPT-4oとGPT-4o mini、Claude Sonnet 4.5とHaiku 4.5、Gemini 2.5 FlashとGemini 2.0 Flashの6種類です。
同記事が伝えた内訳のうち2点が、実務の感覚に近いところです。ひとつは、およそ5件に3件は使える数字がそもそも返ってこなかったという点で、モデルが答えをぼかす傾向が理由として挙げられています。もうひとつは再現性で、同じ質問を約2日後に同じバージョンのモデルへ投げ直したところ、両方で数字を返したケースのうち同一の数字になったのは半分程度だったとされています。ただしこの調査はユニセフのワーキングペーパーで、学術誌への投稿準備中であり査読を経ていません。手法とコードとデータは論文と合わせて公開する予定だと説明されています。数値の位置づけは、この前提込みで読む必要があります。
利用実態の数字も同記事で示されています。ユニセフのデータサイトは月600万件を超えるアクセスがあり、1月1日から9月14日までの比較でChatGPTの回答内リンク経由の訪問が前年同期比67%増、今年のセッション全体の6.4%を占めたとされています。AIアシスタント全体では、訪問のおよそ10分の1にあたるという同機関の推計も紹介されています。
士業事務所にとっての3つの論点
第一に、数字は「返ってこない」ことと「揺れる」ことがある前提で工程を組む余地です。5件に3件で数字が出ず、出たとしても2日後に同じ値が返るとは限らないという結果は、AIに統計を聞いて成果物にそのまま転記する運用とは相性がよくありません。意見書や申請書類、調査報告に数字を載せる場面では、AIの役割を「候補の提示」に寄せ、値の確定は原典で行うという分け方をしている事務所があります。AIの思考過程が追えなくなる局面での検証の置き方でも触れたとおり、確認工程をどこに置くかが設計の要点になります。
第二に、出典に戻れるかどうかが基盤選びの分かれ目になりつつある点です。今回の基盤は各統計の出所を保持し、AIが取得した数値を元の国連の資料までたどれるようにしています。MCPに対応したデータソースが増えると、事務所のAIが外部の一次情報に直接つながる構成は現実的になりますが、同時にどのサーバに何を任せるかという選定の問題が生じます。MCPの仕様は誰がどう決めるのかとMCPのSTDIO設計欠陥をどう読むかで整理した観点は、そのまま接続先を選ぶときの材料になります。参照先を公的情報に限る発想は、公的情報だけを参照する税務相談AIの選定軸でも扱いました。
第三に、権威あるデータを渡してもAIの出力そのものが権威になるわけではない、という点です。TechCrunchの記事でも、モデルは細かな含意を取り違えることがあるため、引用や公表の前に人が出力を確認する必要がある、というGoogle側の説明が紹介されています。データの質の問題と、解釈の質の問題は別に立てる、という整理です。資格者の名義で外に出る成果物では、この確認を誰がいつ行うかを決めておく余地があり、AIエージェントを入れる前に決める権限とログの設計と同じ場所で扱えます。
データの取り扱いについて確認できること
今回公開されたのは公開統計のプラットフォームであり、事務所が入力したデータの扱いとは別の論点です。そのうえで、AIアシスタントからMCPで外部データソースに接続する構成を採る場合、どの接続先にどんなクエリが渡るかは、接続するAIツール側の設定と契約に左右されます。今回の発表資料は基盤側の話であり、事務所が使うAIツールの入力データが学習に使われるかどうか、保存期間がどうなるかは読み取れません。この点は利用中のツールのポリシーで確認する領域で、AIツールのベンダーに何を聞くかの質問項目が使えます。
日本側では、e-Statやe-Gov法令検索が機械可読な形での提供を進めています。統計を成果物に引用する場面については、著作権法に引用を定めた第32条と、出所の明示を定めた第48条の規定が置かれています。個別の引用や利用がこれらの条文との関係でどう評価されるかは、有資格者の判断領域です。なお今回の検証は世界の開発指標を対象としたもので、日本の税務統計や労働統計を尋ねたときの精度がどうなるかは、公表資料からは確認できません。この点は要確認として扱います。
まとめ
国連は統計を1つのAI対応基盤に集約し、MCP経由でAIが直接参照できる形にしました。動機には、開発指標を尋ねた際の平均正答率が21.2%だったという査読前の検証結果があります。数字が返らない、返っても揺れる、という実測が公的機関から出たこと自体が、AIを数字の根拠に使う工程の見直しにつながる材料です。出典に戻れる経路を持つこと、そして出力を人が確認する場所を決めることが、当面の焦点になります。
参考文献
- Making global data easier to explore(Google The Keyword、2026年9月17日)
- UN turns to Google to make its global data ready for AI agents(TechCrunch、2026年9月17日)
- UN System Data Commons(国連)
- Data Commons(Google)
- Data Commons MCP Server(Google Developers Blog)
- 著作権法(e-Gov法令検索)
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: TechCrunch
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。