
ChatGPTの会話を数百人の外部委託者が読んでいると報じられました。
米国の404 Mediaは2026年9月14日、OpenAIが社内で「Project Lily」と呼ぶ取り組みにおいて、数百人の外部委託者に実際のChatGPTの会話を読ませ、応答を評価させていると報じました。ドイツのAI専門メディアThe Decoderも同日、この調査を取り上げています。士業事務所にとって、入力した内容を人が読む可能性があるかどうかは、ツールを使う前提そのものに関わる話です。本記事は報道と各社の公表資料をもとに事実関係を整理したもので、個別の事案の評価は有資格者の領域なので踏み込みません。
Project Lilyとして報じられた事実関係
報じられたのは、OpenAIが外部委託者を雇い、実際の利用者のプロンプトを読ませているという内容です。404 Mediaは、流出した社内文書と実際のプロンプトを確認したうえで、レビュー担当者が会話全体を読むことがあり、内容に機微な個人情報が含まれる場合があると伝えています。同誌によれば、この取り組みの社内呼称がProject Lilyです。
The Decoderがまとめた同誌の報道内容によると、レビュー担当者はChatGPTの応答を1から7の尺度で評価し、過度に人間らしく振る舞う出力や、追従的な出力を減らす作業を担っています。担当者はCrossing Hurdlesを通じて集められ、AI人材企業のMercor経由で報酬が支払われ、北米在住のある担当者は時給50ドルを超えると述べたとされています。担当者は利用者名を見ることはできず、OpenAIはプロンプトがレビュー担当者に届く前に個人情報を取り除こうとしていますが、取りこぼしが起きうることは同社も認めているとされます。
もう一点、士業読者にとって見落とせないのは、この運用がOpenAIに限らないという点です。404 Mediaに対し、Anthropicも自社モデルの改善のために人的レビューを用いていることを認めたと報じられています。Anthropicは学習利用の扱いをプライバシーセンターで公表しており、実際の設定と適用範囲はそこで確かめる形になります。
OpenAIの公表資料には何が書かれているか
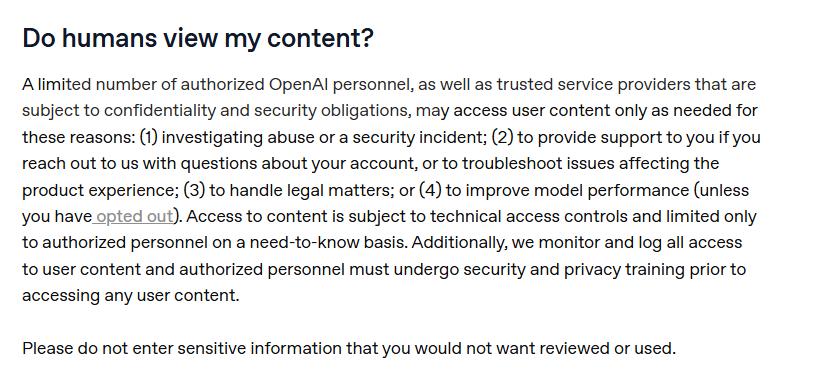
結論から言えば、人が内容を見る場合があること自体は、OpenAIのヘルプページに以前から書かれています。消費者向けサービスのデータ利用に関するFAQには「Do humans view my content?」という項目があり、権限を与えられた自社の担当者と、守秘・セキュリティ上の義務を負う委託先が、不正利用やセキュリティ事案の調査、サポート対応、法的対応、そしてモデル性能の改善という限られた目的のために利用者のコンテンツにアクセスすることがあると説明されています。同じ項目の末尾には、レビューされたり使われたりしたくない機微な情報は入力しないでほしい、という趣旨の注意も置かれています。
同じFAQには、APIやChatGPT Business、ChatGPT Enterpriseといった法人向けの提供については、明示的に同意しない限り、入力内容をモデル性能の改善には使わないと書かれています。つまり個人向けの契約と法人向けの契約では、初期状態の前提が異なるということです。The Decoderは、個人向けの「Improve the model for everyone」という設定が初期状態で有効であり、これを切っても適用されるのは新しい会話だけだと伝えています。加えて、この人的レビューに関する記載は2023年ごろから掲載されており、その後の変更はわずかだとしています。
報道側の論点は、記載が存在するかどうかではなく、その置かれ方が利用者に伝わる形になっているか、という点にあります。「Improve the model for everyone」という表現は、人が会話を読むことへの同意というより、善意の協力を募る言葉に読めるという指摘です。
士業事務所にとっての3つの論点
第一に、契約形態によって前提が変わるという点です。個人のアカウントで使っているのか、法人向けプランなのかで、入力内容の扱いの初期値が違います。地味な作業ですが、事務所で使っているツールがどちらの契約なのかを台帳で押さえておくと、顧客への説明もしやすくなります。プランごとの読み解き方は生成AIの法人プランと学習利用の比較で整理しています。
第二に、設定を切っても過去に遡らないという点です。The Decoderが伝えるとおり設定変更の効果が新しい会話に限られるのであれば、事務所としては「いつから、どの環境で入力したのか」を線引きする話になります。設定の確認手順と限界はChatGPTを学習させない設定の考え方、入力してよい情報の切り分けは顧客情報を生成AIに入力するリスクと対策で扱っています。
第三に、守秘義務との関係を規程の言葉に落とす作業が残るという点です。弁護士については弁護士法第23条が「弁護士又は弁護士であつた者は、その職務上知り得た秘密を保持する権利を有し、義務を負う」と定め、税理士については税理士法第38条が正当な理由なく業務上知り得た秘密を洩らし、または窃用しないことを定めています。顧客の個人データを外部に渡す場面については個人情報保護法第27条の第三者提供の制限が論点として存在します。個別の入力がこれらの条文との関係でどう評価されるかは有資格者の判断領域なので、本記事では立ち入りません。事務所側でできるのは、入力してよい情報の範囲をあらかじめ決めておくことで、その考え方は税理士が生成AIに入れてよい情報の範囲にまとめています。
今後の動きと確認の順番
ベンダー側の開示のしかたは、これから論点になっていくと見ています。OpenAIは2026年8月にゼロデータ保持の継続と新しい安全監視の方針を示しており、その内容はOpenAIがZDR継続と新安全監視を発表で扱いました。人的レビューの存在と、データを保持しない運用の関係がどう説明されるかは、今後の公表資料を追う必要があります。
事務所として確認しやすい順番としては、まず契約しているプランの公式ページで入力内容の扱いを読み、次に管理画面で該当する設定の状態を見て、最後にその結果を規程と顧客向けの説明に反映する、という流れを採る事務所があります。ベンダーに投げる質問の作り方はAIツールのベンダーに何を聞くかにまとめてあります。なお、匿名化処理をどこまで施したうえで誰が閲覧できるのか、レビュー対象になった会話がどれくらい保管されるのかは、今回の公表資料と報道からは読み取れないため要確認です。
まとめ
ChatGPTの会話を数百人の外部委託者が読んでいると404 Mediaが報じ、OpenAIのヘルプページにも人が内容を見る場合があることが以前から記載されていました。法人向けの提供では初期状態でモデル改善に使わないとされている一方、個人向けでは設定が初期状態で有効です。士業事務所としては、契約形態の把握、設定の適用範囲、そして入力してよい情報の線引きを、この順で確かめる段階にあります。
参考文献
- 404 Media Inside ‘Project Lily’: The Humans Reading Your ChatGPT Chats
- The Decoder OpenAI has hundreds of contract workers reading your ChatGPT conversations
- OpenAI Help Center Data Usage for Consumer Services FAQ
- OpenAI Help Center How your data is used to improve model performance
- Anthropic Privacy Center How do you use personal data in model training?
- e-Gov法令検索 弁護士法
- e-Gov法令検索 税理士法
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。