
DeepSeekが新モデルV4.1 Flashを公開しました。
中国のAI企業DeepSeekが、画像とテキストを扱う新モデル「DeepSeek-V4.1-Flash」を公開しました。目を引くのは単体の性能よりも設計思想のほうで、長い文脈を保持するためのメモリを1トークンあたり890バイトまで削り込んでいます。エージェントに長時間作業させるほど費用がかさむという、いまの生成AI運用の構造そのものに手を入れた形です。ただし日本の士業事務所がこのモデルを検討するときには、ベンチマークの数字とは別に確認しておく点があります。公開された内容と、事務所として押さえておきたい論点を順に整理します。
何が公開されたのか
公開されたのは、552B(5,520億)のバックボーンパラメータを持つマルチモーダルMoEモデルと、その重みです。Hugging Faceのモデルカードによれば、対応する文脈長は最大100万トークン、ライセンスはMITとされています。商用利用の制約が緩いオープンウェイトのモデルが、この規模で出てきたことになります。
構造上の特徴は、40層のTransformerを20層の因果エンコーダと20層のデコーダに分けた「Causal Encoder-Decoder」を採用した点です。デコーダ側のKVキャッシュを各層ごとに持たず、エンコーダ最終層の隠れ状態から射影する設計により、1トークンあたりの活性化パラメータは入力処理時で8B、生成時で16Bに抑えられています。同社は、入力量が多いエージェント用途でのコスト効率を上げる狙いだと説明しています。
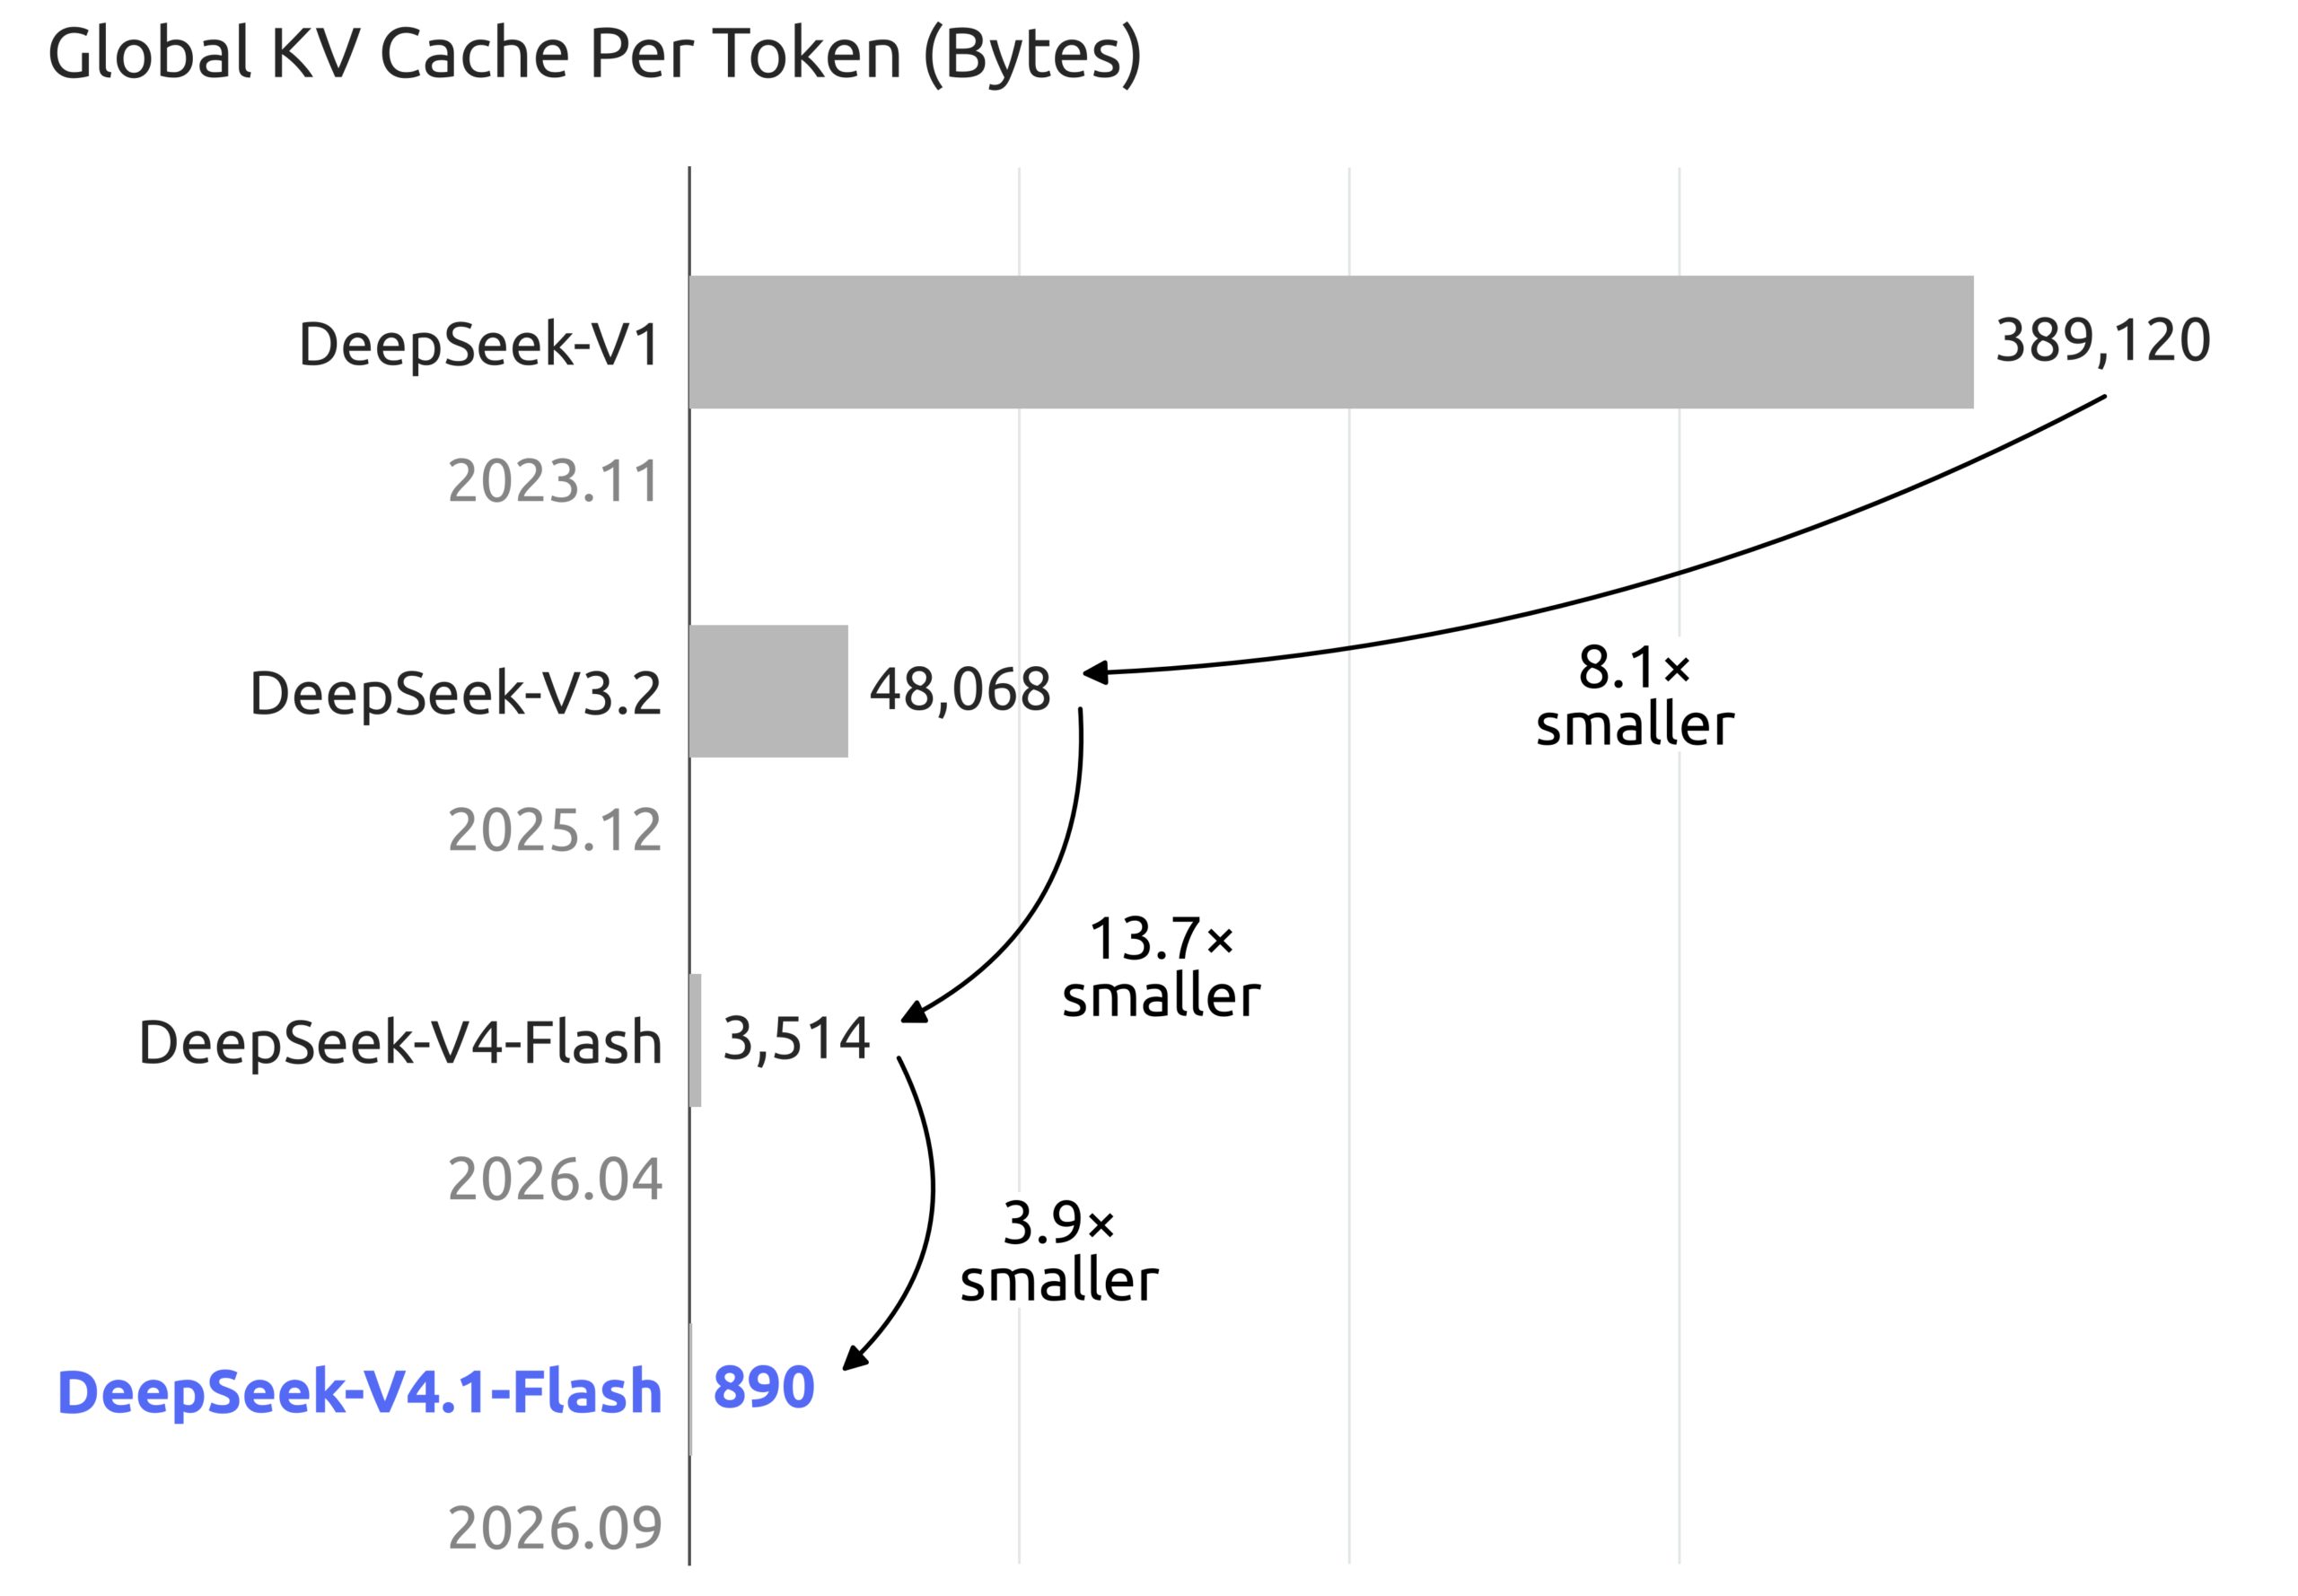
もうひとつが「Compressed Sparse Attention 2」とFP4によるKVキャッシュ格納です。この2つを組み合わせた結果、グローバルKVキャッシュは1トークンあたり890バイトとなり、モデルカードの図では前世代のDeepSeek-V4-Flashのおよそ4分の1、初代DeepSeek-V1と比べるとおよそ437分の1と示されています。事前学習は45兆トークン規模のマルチモーダルコーパスで行われ、推論の深さを1から100の整数で連続的に指定できる設定も備えています。技術的な詳細は同社が公開している技術レポートにまとまっています。
エージェント用途で何が変わるのか
数字としては、エージェント系のベンチマークで上位モデルと並ぶ結果が出ています。モデルカードの比較表では、Terminal-Bench 2.1で90.6、DeepSWE v1.1で74.2、AutomationBenchで54.8、Agent’s Last Examで31.8となっており、いずれも比較対象として挙げられたOpus-5.0やGPT-5.6 Solの数値を上回っています。
ただし全面的に上回っているわけではありません。同じ表でTerminal-Bench 3.0は30.0、4.0は31.2で、Opus-5.0の43.3と51.8には届いていません。推論系のHLEも36.8で、Opus-5.0の56.3とは差があります。難易度の高い課題や長い推論が要るタスクでは、まだ開きがあると読むのが妥当なところです。ベンダーが自ら公表した比較表である点も、割り引いて見る材料になります。
とはいえ、KVキャッシュの削減が効くのは、まさに士業事務所が使いたい場面と重なります。過去の申告書類や議事録、契約書の束をまとめて読ませ、何十ステップも作業させるような使い方では、文脈を持ち運ぶコストが総額を決めます。この構造については、モデル別のコスト設計を扱ったGemini 3.8 Flashの使い分け記事やAIコスト削減の3レバーでも整理しています。
士業事務所が確認する段階にある3つの論点
第一に、モデルの重みを自前環境で動かす話と、DeepSeek社のクラウドサービスを使う話は、データの流れがまったく違うという点です。Hugging Faceで公開されているのは重みであり、モデルサイズは485Bパラメータと表示されています。手元の業務用PCで動く規模ではなく、動かすなら自社サーバか外部のGPU基盤が前提になります。ローカル推論という選択肢そのものの動向は、NVIDIAのローカル推論に関する記事でも触れました。
第二に、同社のサービスを使う場合の取り扱いです。個人情報保護委員会は令和7年2月3日付(令和7年3月5日更新)の情報提供で、同社の生成AIサービスについて、利用に伴い取得された個人情報を含むデータが中華人民共和国に所在するサーバに保存されること、当該データには中華人民共和国の法令が適用されることの2点を挙げています。参考として、中華人民共和国個人情報保護法、サイバーセキュリティ法、データセキュリティ法、国家情報法などが示されています。これは公表資料に基づく情報提供であり、適否の判断そのものではありません。事務所としては、どの情報をどこに置くのかという整理の材料として読む位置づけになります。
第三に、入力データが学習に使われるかどうかです。この点は今回のモデル公開の資料からは確認できません。同社のプライバシーポリシーで最新の記載を確認する段階にあります。守秘義務を負う情報をどこまで生成AIに入力するかという線引き自体は、税理士の守秘義務とAI入力範囲の記事で扱った考え方がそのまま使えます。ベンダーが変われば確認先が変わるだけで、確認する項目は変わりません。
今後の動き
オープンウェイトのモデルが1Mトークンの文脈長とエージェント性能を同時に満たしてきたことで、モデル選定の軸は「どこまで賢いか」から「どこに置けるか」へ広がりつつあります。自前の環境に置けるモデルが実用水準に近づくほど、外部サービスに預けられない情報を扱う事務所にとっては検討の余地が出てきます。
一方で、Hugging Faceのモデルツリーには量子化版が3件並んでいるとはいえ、この規模のモデルを事務所単位で運用するには相応の基盤が要ります。現実的には、国内のクラウド事業者やシステムベンダーがどう提供してくるかを待つ段階です。モデルそのものより、提供形態のほうを見ておくのが実務的だと考えます。
まとめ
DeepSeek-V4.1-FlashはKVキャッシュを1トークンあたり890バイトまで圧縮し、エージェント用途のベンチマークで上位モデルと並ぶ結果を示しました。ただし難易度の高い課題では差が残ります。士業事務所としては、重みを自前で動かす場合と同社のサービスを使う場合を分けて考え、後者については個人情報保護委員会の情報提供を踏まえてデータの置き場所を確認する段階にあります。
参考文献
- Hugging Face deepseek-ai/DeepSeek-V4.1-Flash モデルカード
- DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression(技術レポート)
- 個人情報保護委員会 DeepSeekに関する情報提供
- 個人情報保護委員会 中華人民共和国の個人情報保護制度
- DeepSeek 公式サイト
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。