
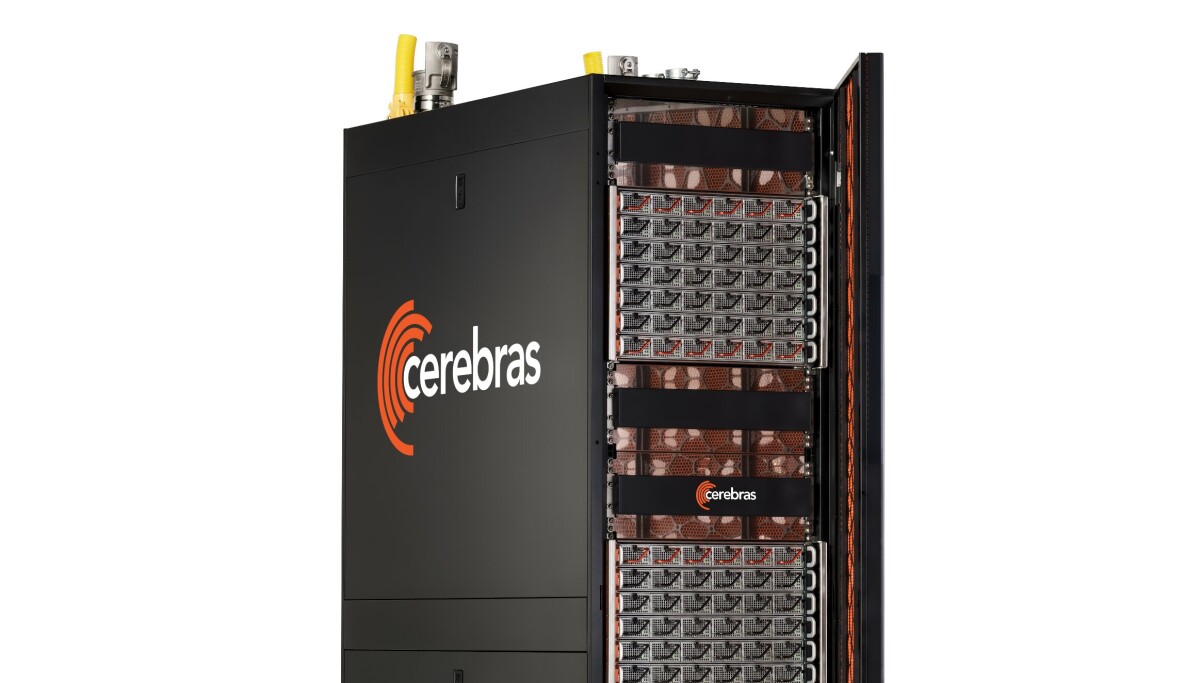
Cerebrasが推論性能2倍の新システムCS-4を発表しました。(出典: The Register)
半導体スタートアップのCerebrasが、AI推論に特化した新システムCS-4と、その中核となるプロセッサWSE-3Tを公表しました。注目すべきは、製造プロセスもトランジスタ数もコア数も前世代とまったく同じまま、性能だけを2倍にしている点です(出典: The Register)。新しいシリコンを作らずに性能を倍にしたという発表であり、AI推論のコスト構造がどこで決まるのかを考えるうえで示唆の多いニュースです。本記事は公表資料と報道をもとに、士業のチカラ編集部が事実を整理したものです。
何が起きたか|新チップを作らずに性能を2倍にしたCS-4
Cerebrasが米国時間2026年8月18日に発表したのは、皿ほどの大きさがあるウェハースケール・プロセッサの新版WSE-3Tと、それを収めるラック型システムCS-4です。The Registerが公開した仕様比較によれば、WSE-3TはウェハーサイズもTSMCの5ナノメートルという製造プロセスも、4兆個というトランジスタ数も、90万という搭載コア数も、44ギガバイトというSRAM容量も、2024年の前世代WSE-3から一切変わっていません。
変わったのは供給できる電力です。同社は電力変換の回路をチップの近くに寄せる設計に改め、基板上での損失を減らすことで、従来の2倍の電力をウェハーに送り込めるようにしました(出典: The Register)。その結果、疎行列前提のFP16演算性能は125ペタフロップスから250ペタフロップスへ、メモリ帯域は毎秒21.6ペタバイトから毎秒43.2ペタバイトへ、チップ間の入出力帯域は毎秒1.2テラビットから毎秒2.4テラビットへと、いずれもちょうど倍になっています。The Registerは動作周波数が1.4ギガヘルツから2.8ギガヘルツに引き上げられたとの推計を示していますが、これは同誌による推定値であり、Cerebrasが公表した数字ではありません。
システム側も作りが変わりました。CS-4は「バックパック」と呼ばれる自己完結型のモジュールを最大3基まで搭載する構成に改められ、HPCwireが掲載したプレスリリースでは1システムあたり750ペタフロップスと案内されています。製品仕様の詳細はCerebrasの公式製品ページで公開されています。最初のCS-4システムは今四半期中に稼働を開始する見込みとされています。
なぜ重要か|推論の勝負どころがメモリ帯域とレイテンシに移った
このニュースが重要なのは、AI推論の性能を決める要素が、単純な演算能力から別のところへ移りつつあることを示しているからです。
大規模言語モデルが文章を1トークンずつ生成する処理では、演算器の速さよりも、モデルの重みをどれだけ速く読み出せるかが上限を決めます。Cerebrasの設計は44ギガバイトという極端に大きなSRAMをチップ上に載せることでこの制約に対処してきました。今回のCS-4では、さらにチップ間の通信レイテンシを5マイクロ秒から2マイクロ秒へ短縮しています。スイッチを介さずチップ同士を2次元トーラス状に直接つなぐ構成に変えたためで、この構成であれば50兆パラメータ規模のモデルまで扱えるとされています。ただしその規模のモデルは現時点で存在しません。
実効性能として示されているのは、オープンモデルgpt-oss-120bを1台のCS-4で動かした場合に利用者1人あたり毎秒4,400トークンという数字です。The Registerは、ベンチマーク事業者Artificial Analysisの計測でGPUベースの最速サービスが毎秒350トークン程度であることと対比しています。電力あたりのスループットは前世代CS-3の10倍とされています。
もっとも、同誌は数字の読み方に注意を促してもいます。250ペタフロップスという値は疎行列を前提にしたもので、大規模言語モデルの推論では疎行列の恩恵が効きにくく、密行列での実力は25ペタフロップス程度とみるのが妥当だという指摘です。メモリ帯域の理論値も、推論時に演算側が使い切れない可能性があるとしています。発表側の数字と第三者の見立てが食い違う典型例であり、性能表示を読むときの目安になります。
構成面でも変化があります。Cerebrasは推論処理のすべてを自社チップで完結させる方針を改め、計算負荷の重いプロンプト処理をAWSのTrainiumとAMDのInstinctに任せ、自社チップは生成部分の加速に集中する分担へ移りました。単独のチップで勝負する段階から、役割の異なるチップを組み合わせる段階に入ったということです。
士業事務所から見た論点
事務所がCS-4を導入するという話ではありません。関係してくるのは、こうした推論基盤の高速化がクラウド経由で提供されるモデルの応答速度と料金に、時間差を置いて反映されてくる点です。長い契約書や大量の議事録を扱う場面で待ち時間が短くなれば、これまで実務に載せにくかった処理が現実的になる余地はあります。
一方で、性能とは切り離して確認が必要な論点も残ります。入力したデータが学習に使われるかどうか、どこのリージョンで処理されるかといった取扱いは、今回の発表資料からは確認できません。事務所が扱う情報は守秘義務の対象を含むため、利用を検討する際は提供事業者の利用規約とデータ取扱いポリシーを個別に確認する段階になります。ハードウェアが速くなったことと、その基盤を経由するサービスが事務所の情報管理方針に合うかどうかは、別々に見ていく必要がある論点です。
今後の動き
The Registerは、SRAM容量がWSE-2以降ほとんど増えていない点を挙げ、次世代のWSE-4では演算性能よりもSRAM容量の拡大が中心になるのではないかとの見方を示しています。プロンプト処理をGPU側に任せる分担が定着するなら、記憶容量を増やすほうが理にかなうという読み筋です。
もう一つの注目点は電力です。The Registerの推計ではCS-4のシステム全体で120キロワットから140キロワット程度とされますが、これはNVIDIAやAMDが年内に投入するとされる240キロワット級のラックと比べれば控えめな水準にあたります。今四半期中とされる実機の稼働開始後に、公表値どおりの速度が実運用で出るのかが次の焦点になります。
まとめ
Cerebrasは新しいチップを作らずに、電力供給の改善だけで推論性能を2倍にしたCS-4を発表しました(出典: The Register)。演算性能よりメモリ帯域とレイテンシが推論の勝負どころになっていること、そして推論をひとつのチップで完結させない分担が進んでいることが読み取れます。事務所にとっては、応答速度の改善が期待できる一方、データの取扱いは別途確認が必要な論点として残ります。
参考文献
- The Register: Cerebras CS-4 rack systems juice chips for every last drop of AI performance
- HPCwire: Cerebras Introduces CS-4 with 750 PFLOPS of AI Compute
- Cerebras 公式 製品ページ(Chip)
- ServeTheHome: Cerebras Intros Faster WSE-3 Turbo Processor and First Rack-Scale CS-4 System
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Register
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。