
Netflixが推薦システムを言語モデルに置き換えた検証結果を公表しました。
Netflixは2026年8月22日、長年運用してきた推薦エンジンを言語モデルベースの新方式「GenRec」に置き換える検証の結果を、同社の技術ブログで公表しました。数千種類の手作りの特徴量を積み上げてきた既存方式に対し、GenRecは視聴履歴を自然文に変換して言語モデルに読ませる方式です。オフライン評価とA/Bテストの双方で既存方式を上回り、二段階目の学習に必要な正解データはおよそ40分の1で済んだと説明されています。汎用の言語モデルが専用設計のシステムを置き換えはじめた事例として、士業事務所のツール選定にも示唆のあるニュースです。
何が起きたか、GenRecの中身と数字
Netflixが公表したのは、既存の推薦ランキングモデルと新方式GenRecを同一条件で比較した検証の結果です。詳細はNetflix Tech Blogに掲載されており、The Decoderが内容を整理して報じています。
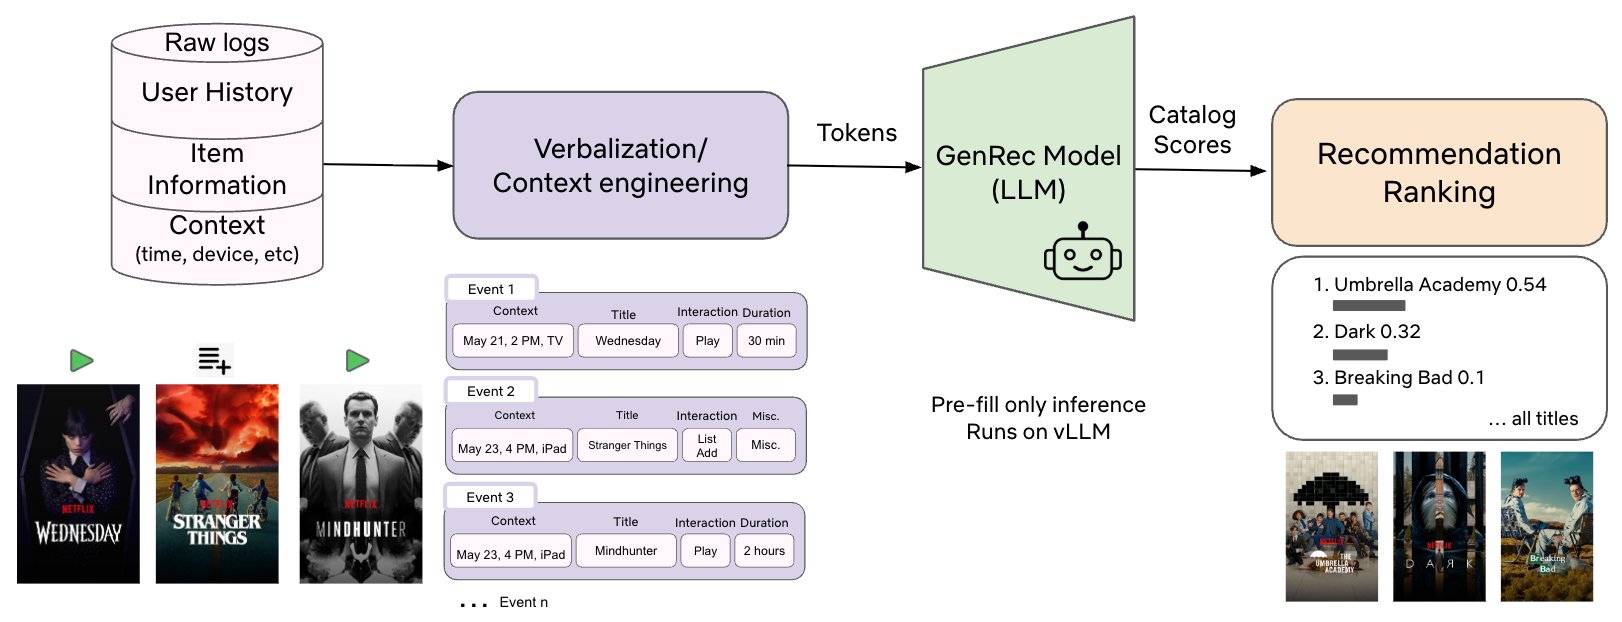
既存方式は、利用者・作品・両者の相互作用について数千種類の特徴量を人手で設計し、積み上げてきたものです。Netflixはこの複雑さが、ゲームやライブ、ポッドキャストといった新しいコンテンツ形式を扱うときの負担になっていたと説明しています。一方で、市販の言語モデルをそのまま使う案も採れませんでした。人気作に偏る、カタログに存在しない作品名を作り出す、事業上のルールを無視するといった問題があったためです。
GenRecはその間を埋める設計になっています。まずオープンウェイトの言語モデルをNetflixのデータで追加学習させ、カタログと利用者行動を理解させます。次に、推薦の順位付けに特化した二段階目の学習を行います。二段階目は新作や嗜好の変化に追随させるため、より高い頻度で更新されます。
数字も具体的です。オフライン評価では既存の本番システムに対しておよそ1.6パーセント高い順位付け精度を示し、二段階目に必要な正解データはおよそ40分の1で済んだとされています。オンラインでは、事前計算される推薦面に限定して全トラフィックの約10パーセントを対象に4週間のA/Bテストを実施し、ホーム画面の短期指標が0.115パーセント、長期の中核指標が0.006パーセント改善しました。Netflixはいずれも偶然では説明できない差だとしています。
なぜ重要か、特徴量設計から文脈設計への移行
このニュースが重要なのは、数字の大きさではなく、置き換えの方向性が示された点にあります。
これまで推薦システムの改善は、どんな特徴量を作るかという勝負でした。GenRecが示したのは、行動ログを自然文に直して言語モデルに読ませ、どの情報をどれだけ入力に含めるかを決める設計に重心が移るという構図です。Netflixはこれを、PLUMやOneRec-Thinkといった研究とも連なる広い流れの一部だと位置づけています。用途ごとに専用アーキテクチャを作るのではなく、単一の言語モデルが複数の用途を引き受ける方向です。
入力を無制限に増やせるわけではない点も率直に書かれています。全ての操作履歴を文章化すると文脈長を超えるため、長時間の視聴のような信号の強い行動は詳細に残し、短い操作は落とし、連続視聴はまとめる、という取捨選択を行っています。ある長さを超えると入力を増やしても精度はほとんど伸びず、計算コストだけが増えるという曲線も示されています。加えて、二段階目の学習を止めて土台のモデルが2週間古くなると、その効きの差が8割ほどに広がるとされています。推薦モデルの鮮度が短命であることを示す数字です。
士業事務所の視点で読むと、ここは他人事ではありません。事務所の中にも、長年かけて人が積み上げてきた判断ルールがあります。問い合わせの振り分け、書類の不備チェック、顧問先ごとの対応パターンといったものです。GenRecの事例は、こうしたルールベースの領域が言語モデルに移りうることと、移した後も継続的な更新がなければ精度が落ちることの両方を示しています。導入したら終わりではなく、運用の型を先に決める話だと読むのが実務的です。なお、Netflixが土台に使ったオープンウェイトモデルの具体名は、公表資料からは確認できません。
今後の動き、全面置き換えはまだ先
Netflix自身は、GenRecを「初期段階ながら有望な一歩」と表現しており、既存システムの全面的な置き換えは現時点で予定していないとしています。今回のA/Bテストも、事前計算される推薦面に限定した部分検証です。
注目したいのは三点です。第一に、この方式が事前計算に頼らないリアルタイムの推薦面まで広がるかどうか。第二に、二段階目の学習をどの頻度で回し続けるのか、その運用コストが公表されるかどうか。第三に、同様の置き換えが推薦以外の業務システムにも波及するかどうかです。数千の手作りルールを言語モデルに寄せる構図は、推薦に固有のものではないためです。
事務所で外部ツールを選ぶ場面では、提供元がこうした内部方式を切り替えたときに、出力の傾向や入力データの扱いがどう変わるかを確認しておく段階だと考えられます。生成AIの承認手順や記録の残し方については、AIによる開発工程に承認ゲートと監査証跡を置く考え方や、MCPの監査ログと書証設計でも扱っています。
まとめ
Netflixは推薦システムを言語モデル化したGenRecの検証結果を公表し、オフライン評価で約1.6パーセントの精度向上、二段階目の学習データはおよそ40分の1で済んだと説明しました。A/Bテストでも有意な改善が確認されています。特徴量を人手で積み上げる設計から、何を入力に含めるかを決める設計へ重心が移る流れを示す事例であり、事務所のルールベース業務を考えるうえでも読む価値のある報告です。
参考文献
- Netflix Tech Blog GenRec: Towards LLM-Native Recommendation at Netflix
- The Decoder Netflix tests language model as alternative to hand-built recommendation logic
- PLUM: Adapting Pre-trained Language Models for Industrial-scale Generative Recommendations
- OneRec-Think
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。