
NVIDIAがオープンウェイトの高速AIモデルを公開しました。
NVIDIAは2026年8月11日、オープンウェイトの言語モデル「Nemotron 3.5 Lightning」を公開しました。総パラメータは316億で、推論時に動くのは36億だけという構成です(出典: The Decoder)。注目されているのは知能スコアの高さではなく、生成速度です。重みが配布されるオープンウェイトのモデルは、自前の環境で動かせるため、外部にデータを出さずに処理したい士業事務所にとって関心の高い領域でもあります。本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。数値はNVIDIAの技術ブログと、独立系ベンチマークであるArtificial Analysisの公表値で確認しています。
公開されたオープンウェイトモデルの中身
Nemotron 3.5 Lightningは、NVIDIAの新シリーズ「Nemotron 3.5」の第1弾です。前身のNemotron 3 Nano 30B A3Bを引き継ぎ、Mambaとトランスフォーマーを組み合わせたハイブリッド構成を維持しています。総パラメータ316億に対し、1ステップで動くのは36億という設計です。
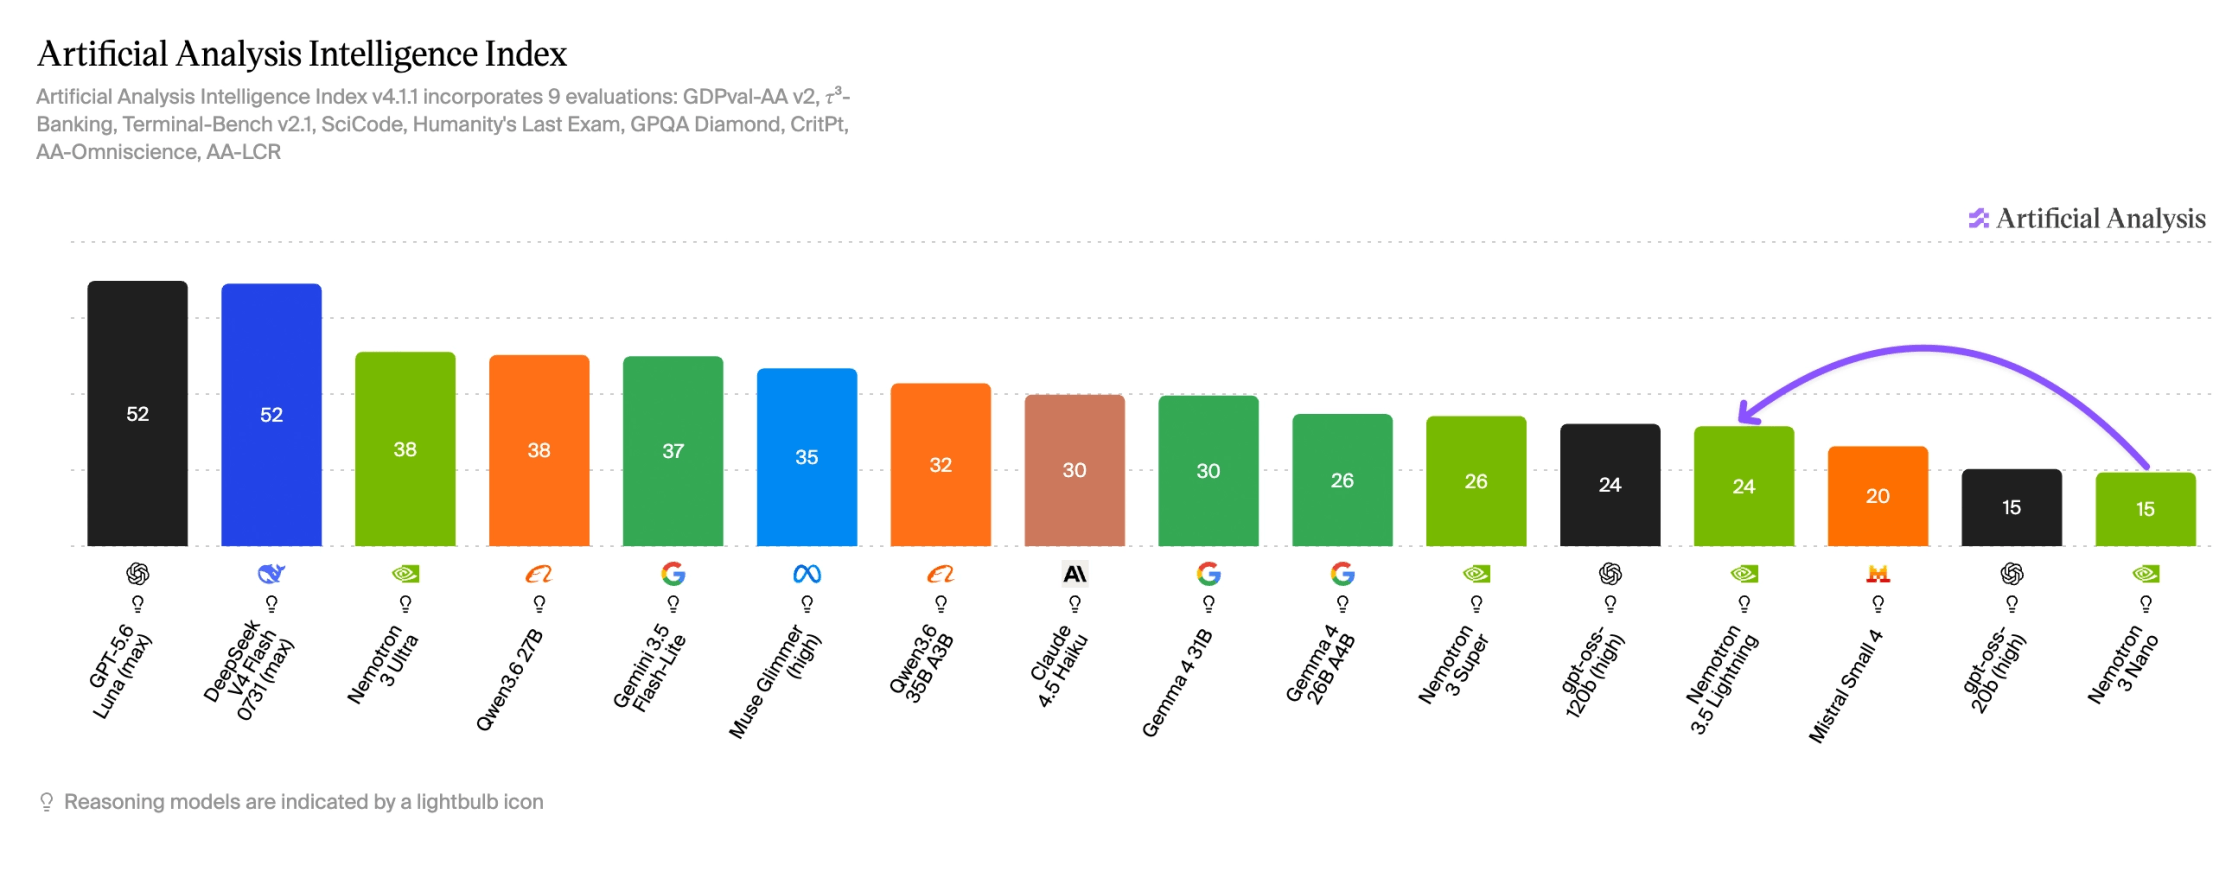
知能面の評価はArtificial AnalysisのIntelligence Indexで24点でした。前身の15点から9点の伸びで、OpenAIのgpt-oss-120bと同点、約4倍の規模を持つ自社のNemotron 3 Superの26点にわずかに届かない位置です(出典: Artificial Analysis)。同じサイズ帯ではQwen3.6 35B A3Bの32点、Metaのオープンモデル系であるMuse Glimmerの35点が先行しており、賢さの序列で頂点に立った発表ではありません。
配布形態も検討材料になります。ライセンスは制約の緩いOpenMDW-1.1で、重みはBF16とNVFP4の2種類がHugging Faceで公開されています。扱えるのはテキストのみで、コンテキストウィンドウは100万トークンとされています。スキャンした紙の書面をそのまま読ませる用途には向かず、OCRなどの前処理を挟む構成になります。
速度とエージェント性能という勝負どころ
このモデルが狙っているのは、賢さの頂点ではなく効率の最前線です。最終版のNVFP4重みを用いた事前計測では毎秒約670トークンに達し、比較対象の中で最も高い処理量だったと報告されています。GoogleのGemini 3.5 Flash-Liteの毎秒386トークンと比べると2倍近い数字です。Intelligence Indexの1タスクを終えるまでの時間は約0.5分で、Qwen3.6 35B A3Bの約3.5分、Gemma 4 31Bの約5.8分と差が開いています(出典: The Decoder、Artificial Analysis)。
伸びが大きかったのはエージェント系のベンチマークです(出典: Artificial Analysis)。GDPval-AA v2では前身から334ポイント上げてEloレーティング824に達し、gpt-oss-120bの800点と、規模の大きいNemotron 3 Superの698点を上回りました。Terminal-Bench v2.1でも7パーセントから24.3パーセントへ改善し、gpt-oss-120bの26.2パーセントに迫っています。長時間動くエージェント処理では、速さがそのまま完了までの時間短縮につながります。
一方で、性能の天井は専有モデルが握ったままです。Gemini 3.5 Flash-LiteはIntelligence Indexで37点、GPT-5.6 Luna(max)は2分未満で52点と報告されています。オープンウェイトが追いついたのは特定の効率領域であって、全面的な逆転ではありません。この構図は、当メディアで以前取り上げたオープンウェイトモデルの安全性ギャップの議論とも重なります。
士業事務所の視点で気になる点
士業の実務に近い論点が1つあります。Artificial Analysisによると、NVIDIAはCodeRabbitとHarveyといったパートナーと組み、特定領域の性能を高める事後学習を行ったと報告されています。Harveyは法務分野向けのAIを手がける企業で、法務ドメインが名指しでチューニング対象に入った点は、法律事務所の周辺で使われるモデルの選択肢が広がる兆しと読めます。100万トークンのコンテキストも、長い契約書や議事録をまとめて渡す使い方と相性があります。ただし公表資料からは日本語の実務文書での精度は確認できず、この点は要確認です。
データの取り扱いも分けて考える必要があります。重みが配布されるモデルは、事務所の管理下にあるサーバーやパソコンで動かせば、入力した内容が外部へ送信されない構成を組めます。守秘義務を負う立場からは、この点がクラウド型サービスとの最大の違いです。ただし同じモデルでも、DeepInfraやFireworksのようなサーバーレス推論経由で使う場合は、各事業者のデータ取扱いポリシーが適用されます。オープンウェイトだから外部に出ない、と一括りにはできません。どの経路で動かすのかを整理し、各社の公表資料を確認する段階です。運用の考え方はローカルLLMのオンプレミス運用で整理しています。
エージェントとして使う場合は、権限設計も検討対象です。速く動くモデルは、誤った操作も速く実行します。どこまでの操作を自動で許すかという線引きは、AIエージェントの権限管理で扱っています。
今後の動き
NVIDIAが効率を重視するのは今回が初めてではありません。同社の研究者は昨年の論文で、100億パラメータ未満のモデルでもエージェント業務の多くを700億から1750億規模のモデルと同等にこなせて、コストは10分の1から30分の1に収まると主張していました。Nemotron 3.5 Lightningは、その主張を製品として示した事例と位置づけられています(出典: NVIDIA技術ブログ)。
Nemotron 3.5はシリーズの第1弾と説明されており、上位モデルの投入が続くかどうかが次の注目点です。事務所側の関心は、最上位モデル1本ですべてを処理する構成から、用途ごとに速いモデルと賢いモデルを使い分ける構成へ移れるかどうかに向かいます。小型で速いモデルが下書きや分類、一次抽出を引き受け、判断が絡む部分は上位モデルと人が担うという分担です。モデル別のコスト感はGemini 3.5 Flashの使い分けでも触れています。
まとめ
NVIDIAのNemotron 3.5 Lightningは、賢さの頂点ではなく毎秒670トークンという速度と、エージェント処理での伸びで存在感を示したオープンウェイトモデルです。士業事務所にとっては、外部送信を伴わない構成を組める選択肢が増えた一方で、サーバーレス経由なら各社のポリシーが適用されるという整理が要ります。日本語実務文書での精度は今後の検証待ちです。
参考文献
- The Decoder「Nvidia’s open-weight Nemotron 3.5 Lightning prioritizes speed over maximum intelligence」
- NVIDIA Technical Blog「NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task Execution for Long-Running Agents」
- Artificial Analysis「Nemotron 3.5 Lightning」モデルページ
- Hugging Face「NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4」モデルカード
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。