
Anthropicは2026年9月8日、AI利用費を下げる3つの手法を公式ブログで公開しました。
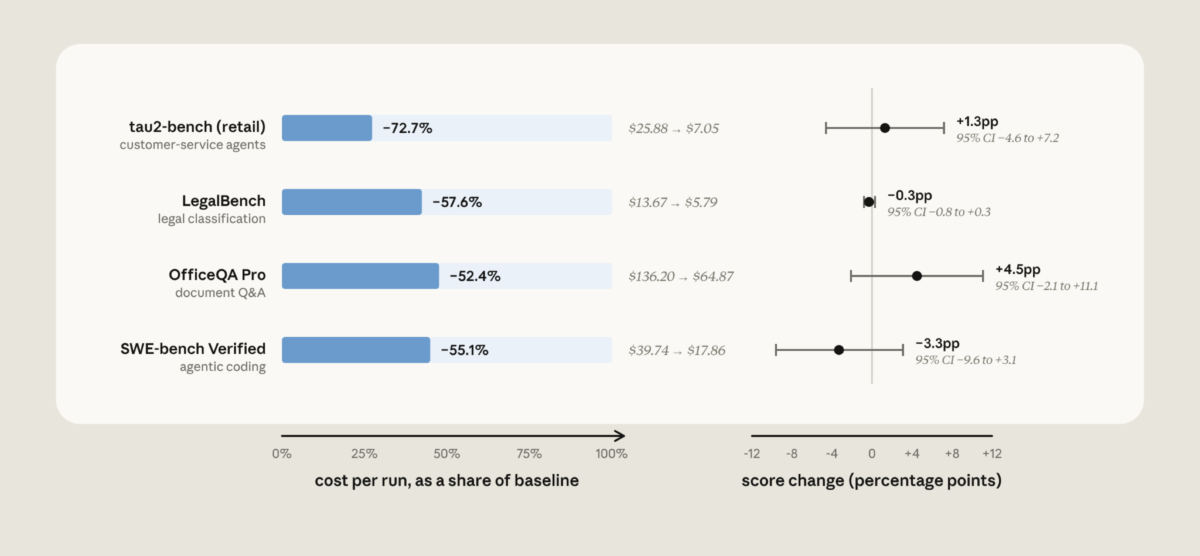
Anthropicが公開したClaude Platform の技術記事(2026年9月8日)は、AIの費用と性能はトレードオフではないという立場を取っています。同記事が挙げるレバーは、プロンプトキャッシュのヒット率、指示文の書き方、effort(どれだけ考えさせるかの設定)の3つです。公開ベンチマークでの実測として、法律タスクを扱う LegalBench で約58%、小売の tau2-bench retail で約73%のコスト削減が、正答率をほぼ維持したまま得られたと報告されています。AIの請求額が読めないという相談は事務所からもよく届きますが、削る先が「使う量」ではなく「設定と書き方」だという主張は、AIコスト削減の議論の出発点を動かすものです。
公開された3つのレバーと、その実測値
結論から言えば、3つのレバーはいずれも上位プランへの移行を伴わない設定変更です。第一がプロンプトキャッシュです。AIは応答を作る前にプロンプトを内部状態へ変換する prefill という処理を行い、ここが入力側の費用の大半を占めます。同じ前置きで始まるリクエストはその状態を読み戻せるため、プロンプトキャッシュの解説ページにある通り、キャッシュ読み出しは通常の入力価格の一部で課金されます。逆に外れると書き直しになり、料金ページの区分では通常入力の1.25倍、1時間キャッシュでは2倍の単価がかかります。外れる原因として同記事(出典)が挙げたのは、システムプロンプトへの動的なタイムスタンプやIDの混入、ツール定義の並び順の変化、会話の途中でのモデルや effort の切り替え、そして既定の5分という保持時間を超えるツール呼び出しの同期待ちです。いずれも「前置きがバイト単位で一致していること」という条件を崩す操作です。
第二が effort の調整です。effort のドキュメントが定義する通り、これはAIに「どれだけ念入りに考えるか」を指定する設定です。同記事の実測では、Claude Fable 5 は難関のコーディング課題群 FrontierCode Diamond で、低 effort が正答率11.5%・1課題5.35ドル、最大 effort が30.9%・19.00ドルでした。スコアは約2.7倍になりますが費用は約3.5倍です。一方 Claude Fable 5.1 で Humanity’s Last Exam(ツールなし)を解かせると、最大 effort への最後の一段は約0.5ポイントの上積みに対して費用が46%増え、その差はベンチマークの実行ごとのばらつきの範囲内だとされています(出典: 前掲 Claude Platform 記事)。高い effort が常に得だとは限らない、という指摘です。
第三が指示文の見直しです。ここが今回のニュースで最も応用範囲の広い部分でした。
「二度確認して」がかえって費用を押し上げる
同記事が挙げた指示文のアンチパターンは、いずれも旧世代のAIの弱点を補うために書き足された類のものです。具体的には、「作業を二度確認してください」といった検証の儀式、「最大限に網羅的に」「重要:常に〜すること」といった強調の上乗せ、固定手順やスクラッチパッドの型、古いモデルの失敗例に合わせた few-shot 例、互いに矛盾する規則、そして旧世代向けの設定値です。
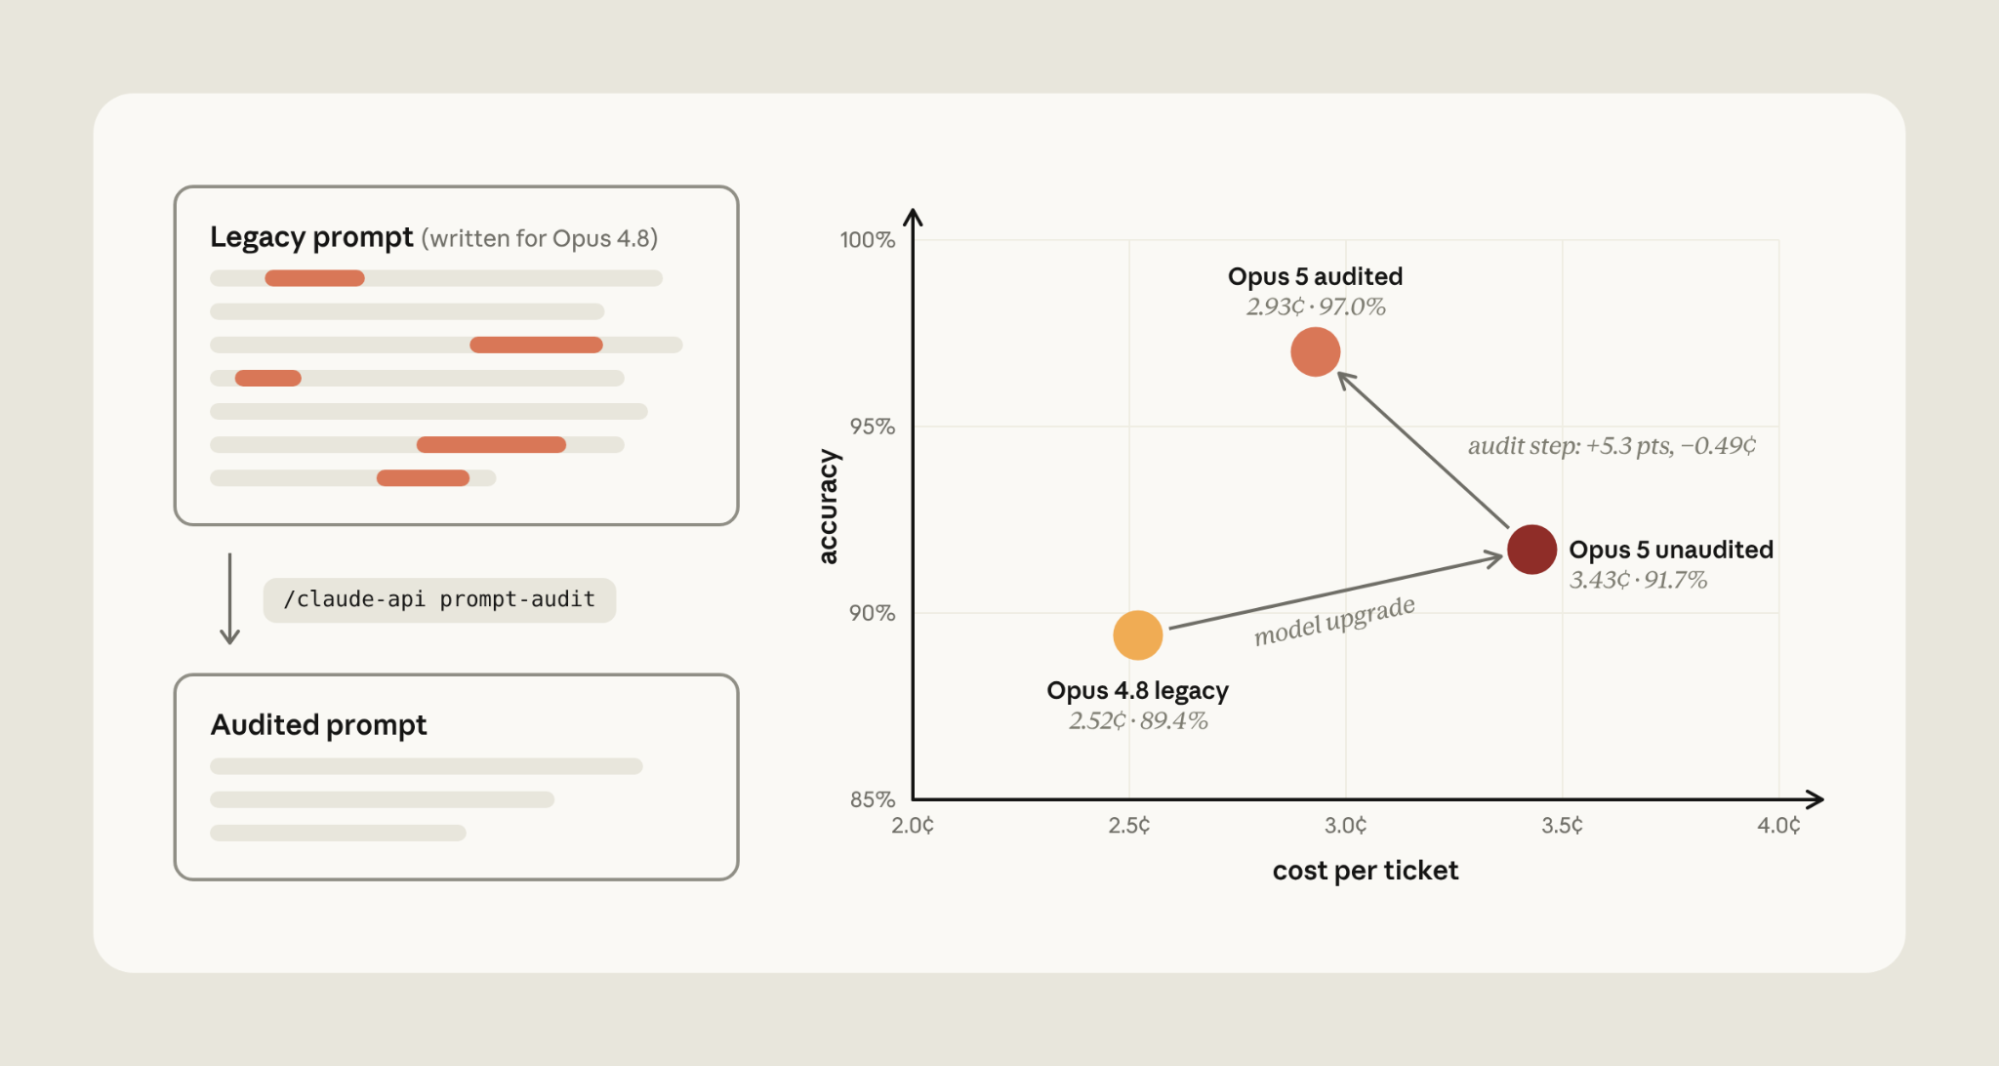
これらは新しい世代のAIに対しては逆効果になると同記事は説明します。指示に忠実になった分だけ字義通りに受け取られ、返金処理のたびに注文照会が重複したり、社内ナレッジ検索が何十回も走ったりして、余分なトークンを使うためです。Anthropicは Opus 4.8 から Opus 5 への移行を想定したカスタマーサポートのベンチマークで、アンチパターンを1つずつ仕込んだ6本のプロンプトを用意し、公開したclaude-api スキルの点検コマンドを1回走らせています。その結果、6本の平均で費用が14.6%下がり、正答率が5.3ポイント上がったと同記事は報告しています。
正答率が上がった理由として挙げられたのは、旧世代向けの思考設定が残っていたためにAPIが振り分けのリクエストを丸ごと拒否していたこと、矛盾した返金規則のせいで本来支払うべき返金を保留していたこと、手書きのスクラッチパッド指示がAIの内蔵の思考と衝突してツール呼び出しが実行されなかったことの3点です(出典: 前掲 Claude Platform 記事)。指示文を足したことが、費用だけでなく品質も下げていたという構図でした。
士業事務所がこのニュースから読み取れること
士業事務所の多くはAPIを直接呼んでいるわけではないため、この記事の内容がそのまま請求額に効くわけではありません。ただし、事務所が自作したプロンプト集や、Claude Code の設定ファイル、業務ごとに用意したスキルの記述は、まさに今回点検の対象とされた種類のテキストです。安全側に倒そうとして「二度確認してください」「網羅的に洗い出してください」と書き足してきた事務所ほど、その積み重ねが費用と品質の両方を押し下げている可能性がある、という読み方になります。
もう一つ目を引くのは、LegalBench で約58%のコスト削減が報告された経緯です。同記事によれば、削減の中身は共通の前置きをタスク間で使い回すキャッシュ設計、低 effort の指定、そして即時性を求めない処理をバッチ処理に回すことでした。思考トークンは102,779から8,284へ減った一方で、正答率はばらつきの範囲に収まったとされています。期限に余裕のある一括処理と、依頼者を待たせる対話処理を分けて設計するという考え方は、繁忙期に処理が集中する士業事務所の業務の形とも重なります。
データの取り扱いについては、今回の記事は費用と性能を主題としており、入力データの学習利用には触れていません。Anthropicの商用プロダクトにおける既定の扱いはプライバシーセンターと商用利用規約に整理されており、守秘義務を負う情報を扱う事務所では、費用の最適化とは別に、契約している区分ごとにこれらの原典を確認する段階にあります。
今後の動き
同社は今回、プロンプトの点検、支出内訳の調査と一括最適化、評価データを使った反復探索という3つのコマンドをclaude-api スキルとして公開しました。各社がモデルの値下げで競ってきた流れに対し、同じ料金表のまま使い方の側で数割を削るという方向を開発元自身が示した点は、今後の比較軸に影響しそうです。
一方で、示された数値はいずれも公開ベンチマークでの測定であり、日本語での実務、とりわけ書式の決まった申請書や長文の契約書を扱う処理で同じ削減率になるかは、公表資料からは確認できません。自事務所の業務で効果を測るには、同じ課題を effort の水準ごとに走らせて費用と正答率を並べる比較が要ります。
まとめ
今回の記事(Anthropic、2026年9月8日)は、AIの費用を下げる手として、プロンプトキャッシュ、指示文のアンチパターン除去、effort の調整の3つを挙げました。公開ベンチマークでは LegalBench で約58%、tau2-bench retail で約73%の削減が、正答率を維持したまま報告されています。旧世代向けに書き足した注意書きが費用と精度の両方を下げていたという指摘は、事務所の自作プロンプトを点検する視点として使えます。
参考文献
- Anthropic Reducing cost and improving performance with Claude Platform
- Claude Platform Docs プロンプトキャッシュ
- Claude Platform Docs effort
- Claude Platform Docs 料金
- anthropics/skills claude-api スキル
- Anthropic 商用利用規約
関連する記事として、Claude Codeのトークン単価と事務所の費用管理、OpenAIが公開したプロンプト指針とslop語ブロックリスト、Claude Fable 5.1の価格改定で変わった3点も併せてご覧ください。
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: Claude by Anthropic
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。