
ChatGPT公開後のWebページの3分の1超にAI文章の兆候があります(Pew Research Center)。
米国の調査機関 Pew Research Center が2026年8月20日、英語圏のWebページ約49万件を解析した結果を公表しました。2026年7月時点の無作為抽出では全体の10パーセントにAI文章の兆候があり、ChatGPT公開後に作られたページに絞ると3分の1超まで跳ね上がります(出典は同分析)。士業事務所は法令・実務情報の裏取りでWebを日常的に使います。その母集団の質が数年で大きく変わったことを、一次データで確認できる材料が出てきたという受け止めです。
何が公表されたか、49万ページの解析結果
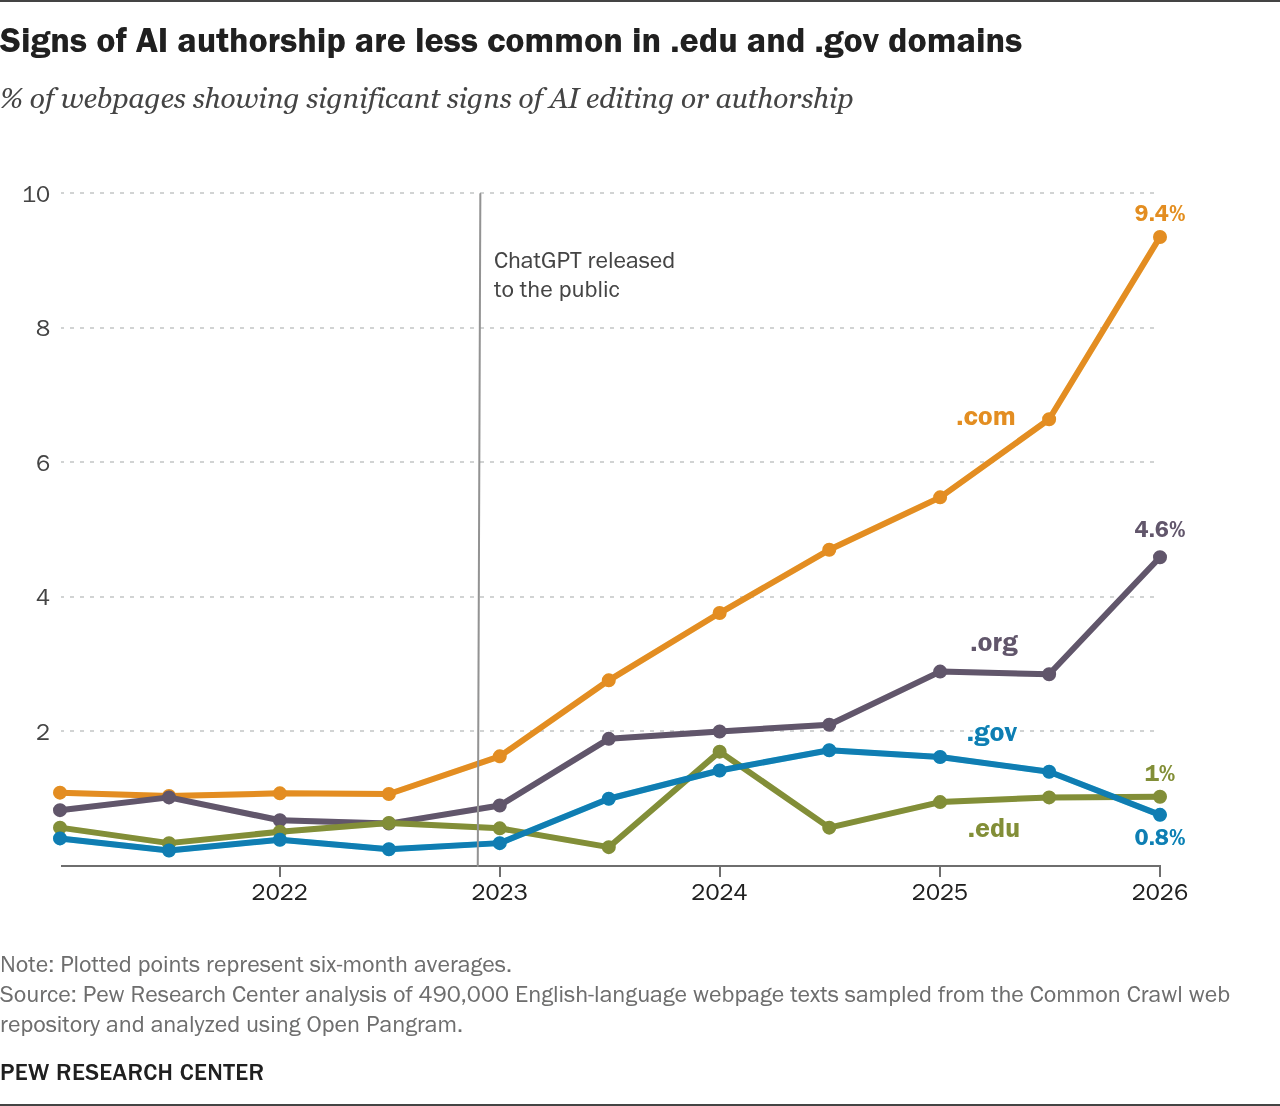
公表されたのは、WebアーカイブのCommon Crawlから2021年1月〜2026年7月に収集した英語ページを、AI判定モデルOpen Pangramにかけた分析です。対象は約49万ページ、2026年7月分の無作為抽出1万ページのうち10パーセントに「AIによる執筆または大幅な編集の明確な兆候」が見られたとPew Research Centerは説明しています。
数字が一気に動くのは、ChatGPT公開前の古いページを除外したときです。同じ2026年7月のスナップショットでも、2022年11月以降に公開されたページに限れば3分の1超がAI文章の兆候を示しました。この上昇は2022年末から途切れず続いており、Claude や Gemini など他のチャットボットが加わった時期にも傾きは戻っていないと同分析は記しています。ドイツのAI専門媒体The Decoderもこの結果を取り上げ、商用サイトへの偏りを論点として挙げました。
ドメインで10倍の差、士業の情報収集で効く読み方
士業実務にとって示唆が大きいのは、AI文章の分布がドメインによって大きく偏るという点です。2026年のサンプルでは、.com が約10パーセント、.org が4.6パーセント、.edu と .gov はいずれも約1パーセントでした(Pew Research Center)。商用ドメインは教育機関や政府機関の10倍前後という開きです。
日本の士業が扱う一次情報は、e-Gov・国税庁・厚生労働省・特許庁・各職能団体といった go.jp と or.jp に集中します。今回の調査は英語圏が対象なので日本のドメインにそのまま当てはめることはできませんが、「一次情報の原典に当たる」という従来からの作法が、AI文章の増加という観点からも合理的だと裏付けられた形です。逆に、解説記事や事務所ブログをまとめた商用サイトから孫引きすると、検証されていない記述を拾う確率は以前より上がっていると読めます。生成AIが作った架空の判例に振り回されないための工程は生成AIの架空判例を検証する手順でも整理しています。
AI文章の「くせ」と、判定ツールの限界
Pew は、AIが好んで使う表現の出現頻度も測っています。2023年と比較して、em ダッシュ(—)が約2倍、オックスフォードカンマが63パーセント増、delve・interplay・testament・pivotal・tapestry といったAI好みの語彙が2倍超、「it’s not just X, it’s Y」型の否定的並列がほぼ3倍でした(Pew Research Center)。日本語にそのまま対応する指標ではありませんが、機械的な文体のくせが統計として観測できることを示す結果です。
同時に、Pew は判定の限界も明示しています。検出モデルは人間が書いた文書をAI判定したり、その逆をしたりする誤りを起こすため、個々のページの断定には使えないという説明です。The Decoder も、全自動生成と人間の下書きをAIで整えたものを現行ツールがほとんど区別できない点を指摘しました。つまり「AI文章の割合」という数字は傾向を見るためのもので、目の前の1本を白黒つける道具ではないという整理になります。
なお、この種の判定ツールに事務所の文書を投入する場合、入力データが提供事業者側でどう扱われるかは、今回の公表資料からは確認できません(要確認)。Open Pangram はオープンウェイトのモデルとして公開されていますが、外部のホスティング型サービス経由で使うのか、手元で動かすのかによって前提が変わります。守秘義務の対象を含む文書を扱う場面では、利用形態ごとに提供元の公表資料を確認する段階です。
事務所の初動として挙がっている確認
第一に、調査の出発点を go.jp と or.jp に固定し、商用ドメインの解説記事は補助的な位置づけにとどめるという運用があります。第二に、AI検索やチャットボットが提示した根拠URLについて、原典ページを開いて記述と突き合わせる工程を残す事務所があります。AI検索を調査実務に組み込むときの検証工程にまとめた考え方と同じ発想です。
第三に、自事務所が発信する記事や事務所ブログについて、AI生成物の表示や社内の確認記録をどう残すかを決めておく動きがあります。この点はAI生成物の表示ルールを事務所規程に落とす論点で扱いました。第四に、AI判定ツールのスコアを個別文書の真偽判定に使わないという前提を、所内で共有しておく確認が挙がっています。
まとめ
Pew Research Center の分析は、ChatGPT公開後のWebページの3分の1超にAI文章の兆候があり、.com と .gov・.edu で10倍前後の差があることを示しました。士業の情報収集にとっては、一次情報の原典に当たるという従来の作法の価値が上がったという読み方ができます。判定ツールのスコアは傾向把握までで、個別文書の断定には使えないという限界も同時に示されています。
参考文献
- Pew Research Center「How Much of the Internet Is Written With AI?」(2026年8月20日)
- Pew Research Center 調査手法(Methodology)
- The Decoder「Pew study confirms sharp rise of AI-written text on the web since ChatGPT’s launch」(2026年8月24日)
- Pangram「Introducing Open Pangram」
- Common Crawl
※士業のチカラでは、生成AIの導入支援から運用最適化まで、貴事務所の業務に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://shigyonochikara.jp/contact/
引用元: The Decoder
本記事の作成体制について
本記事は士業のチカラ編集部が、公表されている一次情報のみを根拠に作成しています。法令の条文はe-Gov法令検索の原文で、行政の見解は各府省庁の公表資料で、それぞれ確認したうえで記載しています。引用元は本文中および参考文献にすべて明示しています。
本記事には特定の資格者による監修は入っていません。個別の事案について法令の当てはめや手続の可否を判断する必要がある場合は、当該分野の有資格者にご相談ください。本記事は一般的な情報提供を目的としたものであり、個別具体的な法律判断・税務判断・労務判断を提供するものではありません。
記載内容に誤りを見つけられた場合は、お問い合わせよりご指摘ください。確認のうえ速やかに訂正し、訂正履歴を記事内に残します。編集方針の詳細は運営者情報をご覧ください。